
エビデンスが支持する学習法、支持しない学習法
アプリを作る前に学習法を調べた理由
このサイトとAI Maker Labチャンネルは私が所有し、制作しています。これは制作記録であり、第三者による独立したレビューではありません。
再読とハイライトは、私が最もよく使っていた二つの学習法でした。見慣れたページを読んでいる間は、前進しているように感じました。
学習アプリはまだ存在しません。この記事は、その設計に反映するための調査を報告するものであり、アプリの成果を主張するものではありません。
機能を選ぶ前に、条件と限界を含むエビデンスの一覧を作りたいと考えました。
要点:
- この記事の基礎となるレビューでは、練習テストと分散学習が高い有用性評価を受けました。
- インターリービング練習、自己説明、精緻化質問は、中程度の有用性評価を受けました。
- 要約、ハイライト、キーワード記憶術、文章学習におけるイメージ利用、再読は、低い有用性評価を受けました。
- 以下の複合的な学習法は、すべてが同じエビデンス基盤を共有しているわけではないため、構成要素を個別に扱います。
- 学習マップと習熟度表示は、この調査から着想を得たプロダクト案であり、アプリで測定した結果ではありません。
十の学習法とその有用性評価
Dunloskyらは2013年のレビューで、十の学習法を三段階の有用性に分類しました。高評価は練習テストと分散学習、中評価は精緻化質問、自己説明、インターリービング練習、低評価は要約、ハイライト、キーワード記憶術、文章学習におけるイメージ利用、再読です。
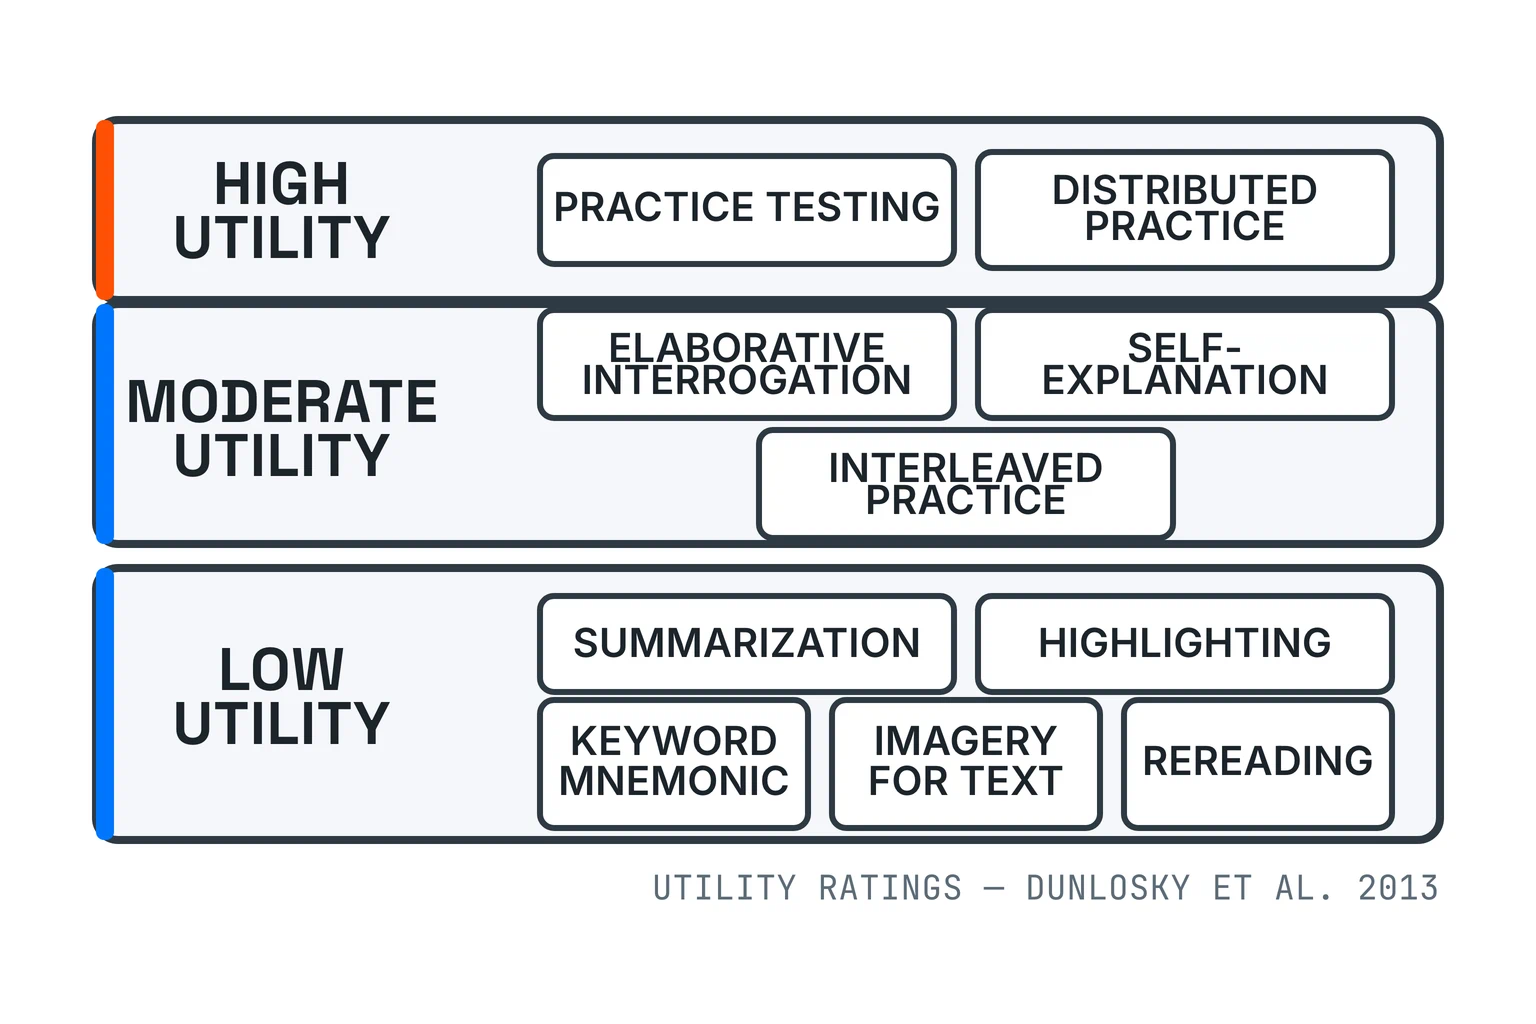
この評価枠組みが問うたのは、効果が学習条件、学習者の特性、教材、評価課題を越えて一般化するかどうかです。効果量を順位付けした表ではありません。
高評価の二つの学習法は、年齢や能力の異なる学習者、多様な評価課題、教育状況で利点が見られたため、その評価を得ました。ただし、この統合結果からも、すべての学習者や科目で同じ効果が得られるとは言えません。
中評価は効果がないという意味ではなく、低評価も役に立たないという意味ではありません。著者らは、エビデンスの範囲や量が限られている場合や、効果がそれほど広く一般化しない場合にも、これらの評価を用いました。この三段階は、条件付きの意思決定支援です。
アクティブリコールと間隔反復:エビデンスが示すこと
見出しのアクティブリコールは、編集上の呼び名として使っています。以下の研究では、練習テスト、反復テスト、分散学習という、それぞれの用語が使われています。
RoedigerとKarpickeの第二実験は、タイミングに伴うトレードオフを具体的に示しています。文章を学習してから5分後の再生率は、4回学習した群が83%、3回学習して1回テストした群が78%、1回学習して3回テストした群が71%でした。
1週間後には順序が逆転しました。1回学習して3回テストした群は61%、3回学習して1回テストした群は56%、4回学習した群は40%でした。この遅延後の順位における最初の群間差は有意傾向にとどまり、著者らはテスト効果が成立する境界条件はまだ分かっていないと述べています。
Cepedaらは、184本の論文に含まれる317件の実験から839件の評価を統合し、再生を結果指標とする言語記憶課題に対象を限定しました。集中学習と間隔を空けた学習を比較した271件では、最終テストの平均正答率が間隔学習で47.3%、集中学習で36.7%でした。一方、12件の比較では効果がないか、負の間隔効果が見られました。
最大の保持に結び付いた学習間隔は、意図する保持期間が長くなるほど長くなりました。ただし、遅らせるほど常によいという単純な規則ではなく、エビデンスが少ない間隔の組み合わせもありました。
MurreとDrosは、1人の参加者と節約法を用いてエビングハウスの忘却曲線の形を再現し、その曲線が完全には滑らかでなかったと報告しました。図では、その定性的な減衰の形と間隔効果の原則を組み合わせています。復習を時間上に配置していますが、すべての学習者、教材、目標に一つの予定表を処方するものではありません。
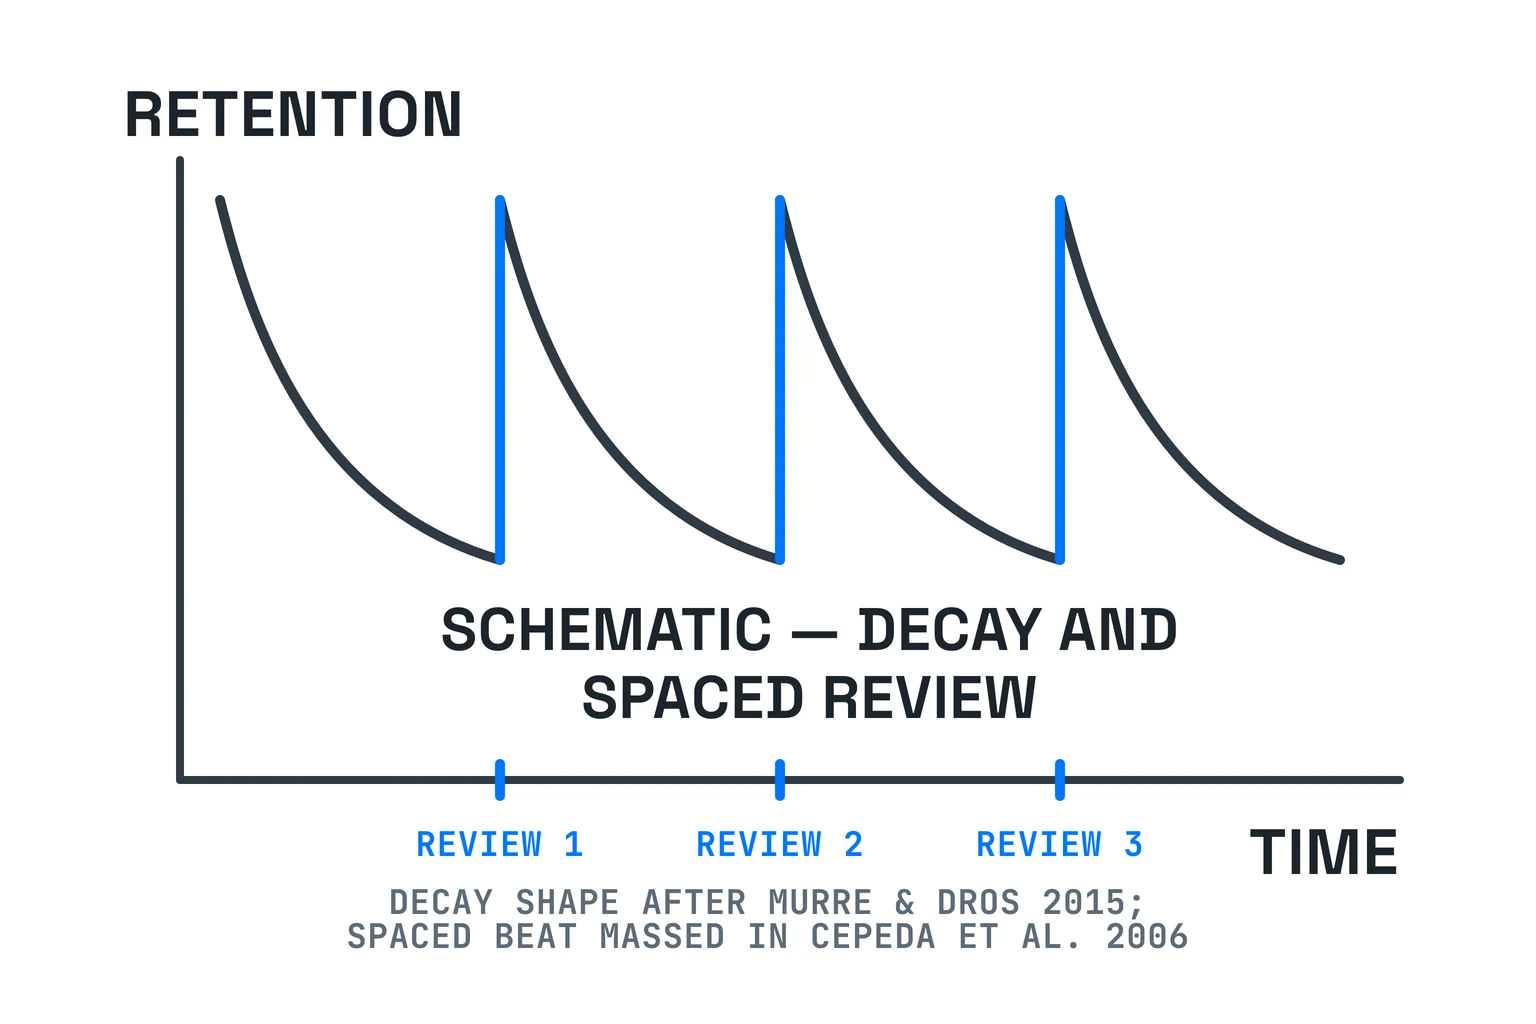
アプリにとっては、普遍的な予定表ではなく、エビデンスと前回学習からの経過に基づいて復習を組むという意味になります。また、学習直後の一度の成功を、長期的な保持として扱うべきではありません。
インターリービング、自己説明、精緻化質問:条件とコスト
RohrerとTaylorの第二実験では、ある大学の学部生18人が、四種類の立体体積問題について三つのセッションをすべて完了しました。1週間後の得点は、混合練習が63%、ブロック練習が20%でした。著者らは標本が小さいことを指摘しています。
コストは練習中に現れました。混合群の得点は60%、ブロック群は89%でした。この不慣れな数学課題では、遅延後の結果を高めた練習スケジュールのほうが、取り組んでいる最中には悪く見えました。
この結果から、すべての科目でインターリービングを使うべきだとは言えません。この研究が扱ったのは一つの課題であり、出版社は要旨と図を公開していましたが、全文は有料でした。
自己説明と精緻化質問は、実際の教育状況からのエビデンスが不十分であることを含め、レビュー著者らが有効性のエビデンスは限られていると判断したため、中程度の有用性にとどまりました。支持の範囲が狭い、役立つ可能性のある手段ではありますが、どの授業にも自動的な改善をもたらすものではありません。
再読、ハイライト、要約:有用性評価の低い習慣
レビューが調査した文献では、再読とハイライトは、学生が最もよく使うと報告した学習法でした。レビューは、これらが学生の成績を一貫して改善しなかったと判断し、代わりに別の学習法を推奨しました。
要約も低い有用性評価を受けました。この評価にも、ほかの段階と同じ条件があります。エビデンスや一般化可能性が限られていることは、その学習法が決して役立たないという所見と同じではありません。
私自身の経験は、さらに狭いものです。再読とハイライトは私が最もよく使っていた二つの学習法で、見慣れたページを読んでいる間は前進しているように感じました。これは私自身の学習歴であり、ほかの学習者について測定した結果ではありません。
プロダクトへの誠実な示唆は、読むこと、ノートを取ること、ページに印を付けることを禁じることではありません。教材に触れたことや見慣れた感覚だけを、次のトピックへ進むための十分な証拠として扱わないことです。
レイヤー型学習とそのほかの複合的な学習法
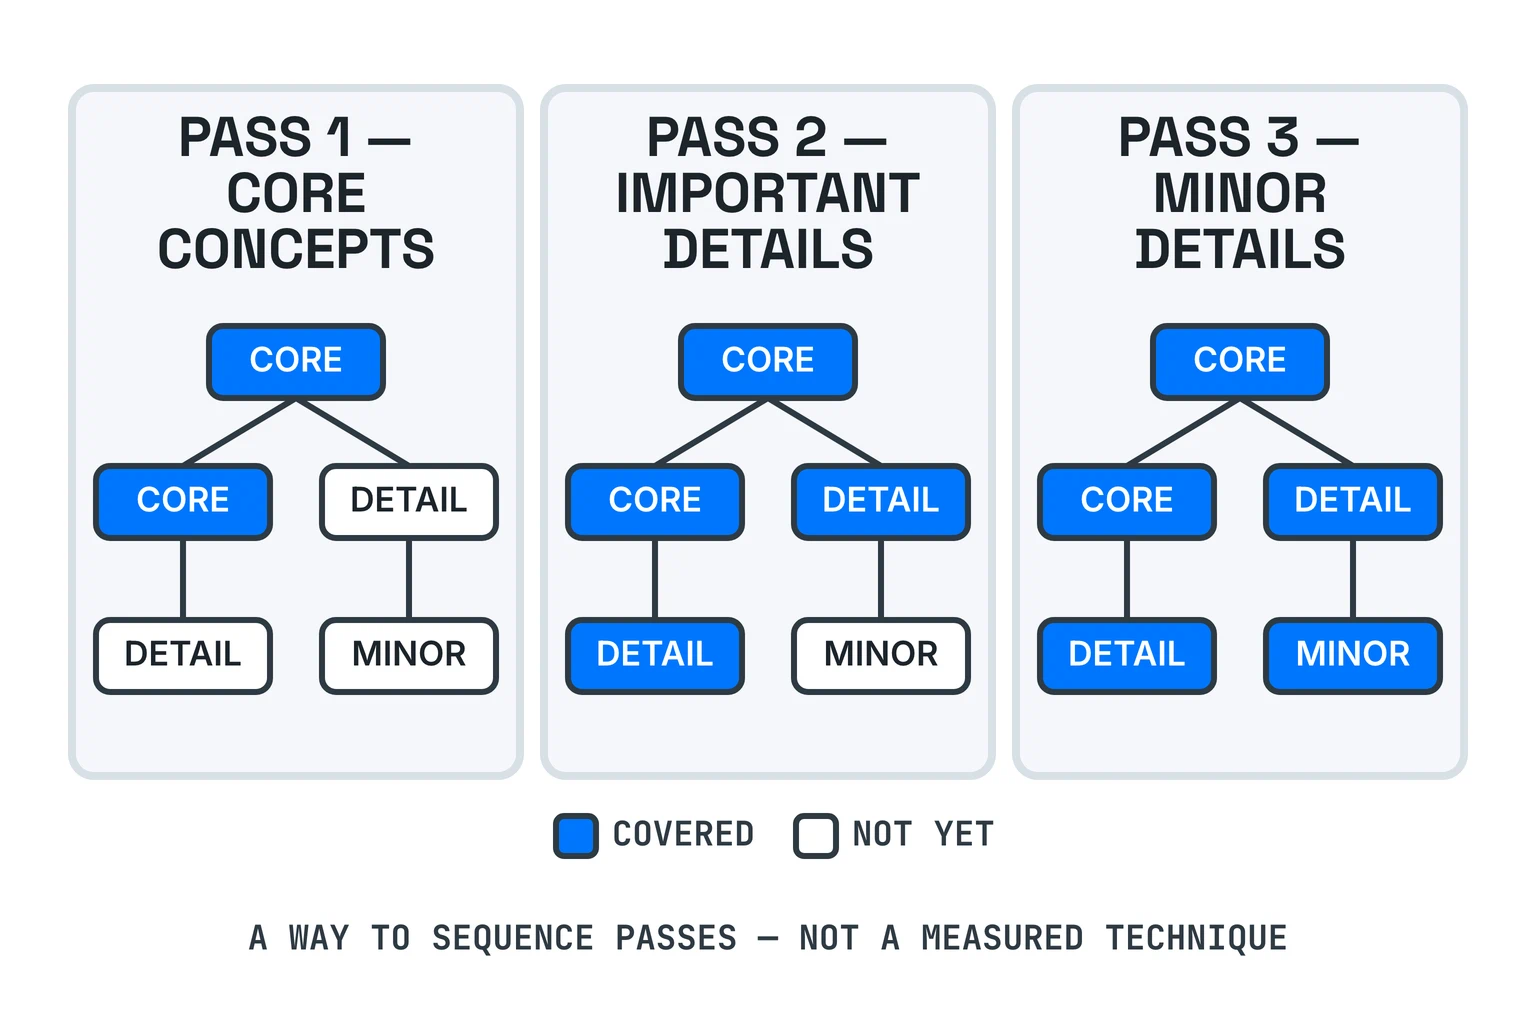
2026-08-23に実施した範囲限定の検索では、中心概念、重要な詳細、細かな詳細の順に進む、三段階パッケージそのものを直接評価した査読済みの有効性研究は見つかりませんでした。この検索は、PubMedとERICでの完全一致検索と、より広いウェブ検索を対象にしましたが、研究がどこにも存在しないと立証するものではありません。
そのため、レイヤー型学習は、直接評価された学習法ではなく、構成を整えるための戦略として扱います。三回のパスは、同じトピックマップを学ぶ順序を与えますが、このパッケージ自体は、範囲限定の検索では未測定のままです。
Keshavの各パスでは、まず全体像、次に詳細を除いた内容、最後に論文をほぼ再実装する段階へ進みます。前提を立て、研究内容を再現し、実際の論文と比較します。これはソフトウェア実装でも実験の追試でもありません。その根拠は15年間の個人的実践であり、実験ではありません。
名前の似たレイヤード・カリキュラムは、C、B、Aという活動レベルを持つ別のモデルです。2025年のメタ分析は、トルコの大学院学位論文13本から41の効果量を報告し、変量効果による推定値は0.80(95% CI 0.616〜0.988)でした。この結果は、ここで説明する三段階パッケージを評価したものではありません。
隣接する順序付けの要素には、それぞれのエビデンスがあります。135件の研究を対象としたメタ分析では、先行オーガナイザーに小さな促進効果が見られました。ある大学の心理学入門を履修する学部生164人を対象とした一つの実験では、各文章の直前に目標を置いた場合のテスト得点は.55、目標なしでは.47でした。一方、すべての目標を最初にまとめて置いても差はありませんでした。
教えるつもりで学ぶことも隣接する考え方ですが、エビデンスは一貫していません。Nestojkoの第一実験では、教えるつもりで読む条件によって、アイデア単位の自由再生率が.13から.17へ上がり、元の文章により近い構成で再生されました。ただし、実際に教えた参加者はいません。第二実験では全体的な優位性は見られず、情報の種類との交互作用と、要点における有意傾向の優位性だけが見られ、詳細には効果がありませんでした。
意図的練習は、単なる反復よりも狭く定義されています。Ericssonらの枠組みでは、課題は現在の弱点を対象とし、即時の有益なフィードバックを与え、関連する練習を繰り返し、適切な場合に難易度を上げます。この枠組みでは、十分なフィードバックがなければ改善は最小限だとされています。
その寄与は分野によっても異なります。2014年のメタ分析では、意図的練習が成績の分散を説明する割合は、ゲームで26%、音楽で21%、スポーツで18%、教育で4%、専門職で1%未満と報告されました。これらは説明された分散の割合であり、因果的な効果量ではありません。
Bloomの完全習得学習は、コースを小さな単元に分け、診断的な進捗テストを行い、未習得の場合は修正学習を指示し、依存する学習へ進む前に十分な習得を求める手順でした。一律の数値基準を定めたものではありません。
Bloomによる1984年の2シグマの議論は、4、5、8年生の四標本、二科目、3週間で11回の授業時間を対象としていました。その特定の条件下で、形成的テストと修正学習を含む個別指導は対照群より約2標準偏差高く、完全習得学習だけでは約1標準偏差高かったと報告しました。
就学前から高校までを対象にした個別指導のフィールド実験について、2024年のシステマティックレビューでは、統合効果が0.288標準偏差と報告されました。教師または教育補助員が指導する場合、低学年、週3回以上、校内での実施で、より大きな効果が見られました。成人の独学やアプリを測定した研究ではありません。
108件の対照評価を対象としたメタ分析では、完全習得学習プログラムが試験成績に正の効果を持ち、学力の低い学生ほど効果が大きく、手順、研究設計、内容によってばらつくとされました。またコストも報告され、自己ペース型では大学の科目修了率が低下することがよくありました。
学習マップで最初に学ぶことを示す方法
学習マップとは、トピックと前提関係をグラフにし、選んだ目標に関連する一つの経路を強調するものを指す、私自身の呼び名です。次に何を学ぶかという問いに答えるための案であり、一つの順序がすべての学習者にとって客観的に正しいとする主張ではありません。
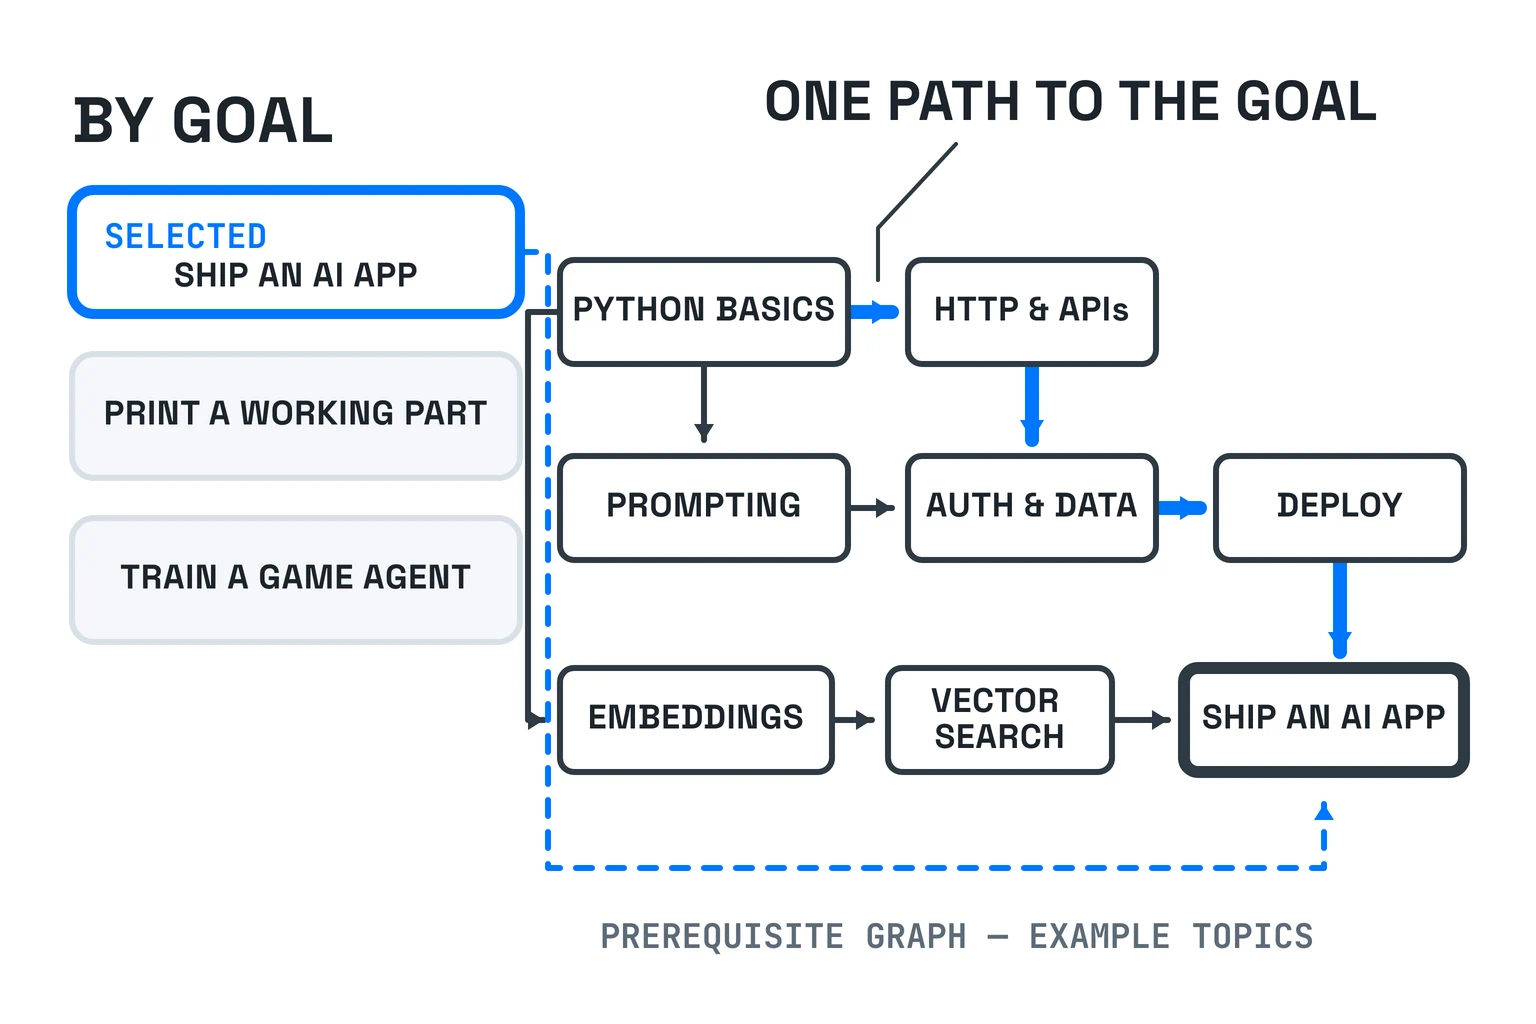
概念マップは、概念を枠で表し、関係を示すラベル付きの線で結びます。NovakとCañasは、焦点となる問いを中心に、一般的な概念をより具体的な概念の上に配置します。また、マップは一つの普遍的な科目順序を示すものではなく、文脈に依存すると強調しています。
2006年のメタ分析は、参加者5,818人を含む55件の研究から67の効果量を抽出しました。概念マップの利用は知識保持の向上と関連し、平均効果は、マップの使い方と比較対象によって小から大まで幅がありました。
知識空間理論は、学習者の状態を一つの得点ではなく、その分野で解ける問題の部分集合としてモデル化します。形式的な定義では、任意の和集合について閉じている実行可能状態の集合が知識空間を構成し、その空間は特定の種類のAND/ORグラフに対応します。
実際に導入された初等代数の一つの構造には、約60,000の知識状態と、実行可能な経路が数十億通りありました。外縁は次に学ぶ準備が整った内容を表し、内縁はつまずいた後に復習する価値のある習得済みの内容を表しました。
同じ著者らは、専門家の判断だけでは前提構造を検証できないと警告しました。学習者のデータを必要とし、その初等代数の構造では、予測した反応と観測した反応の相関が約.7〜.8だったと報告しています。
コンピューティング・カリキュラムの一事例では、望ましい成果、トピック、コースを前提関係の辺で結ぶグラフのノードとしてモデル化し、トピックをトポロジカルソートして指導順序を作りました。このグラフには、望ましい成果150件、トピック1,232件、前提関係の辺2,295本があり、トピックの15.7%はどのコースでも扱われていませんでした。
学習の進捗と習熟度を可視化する方法
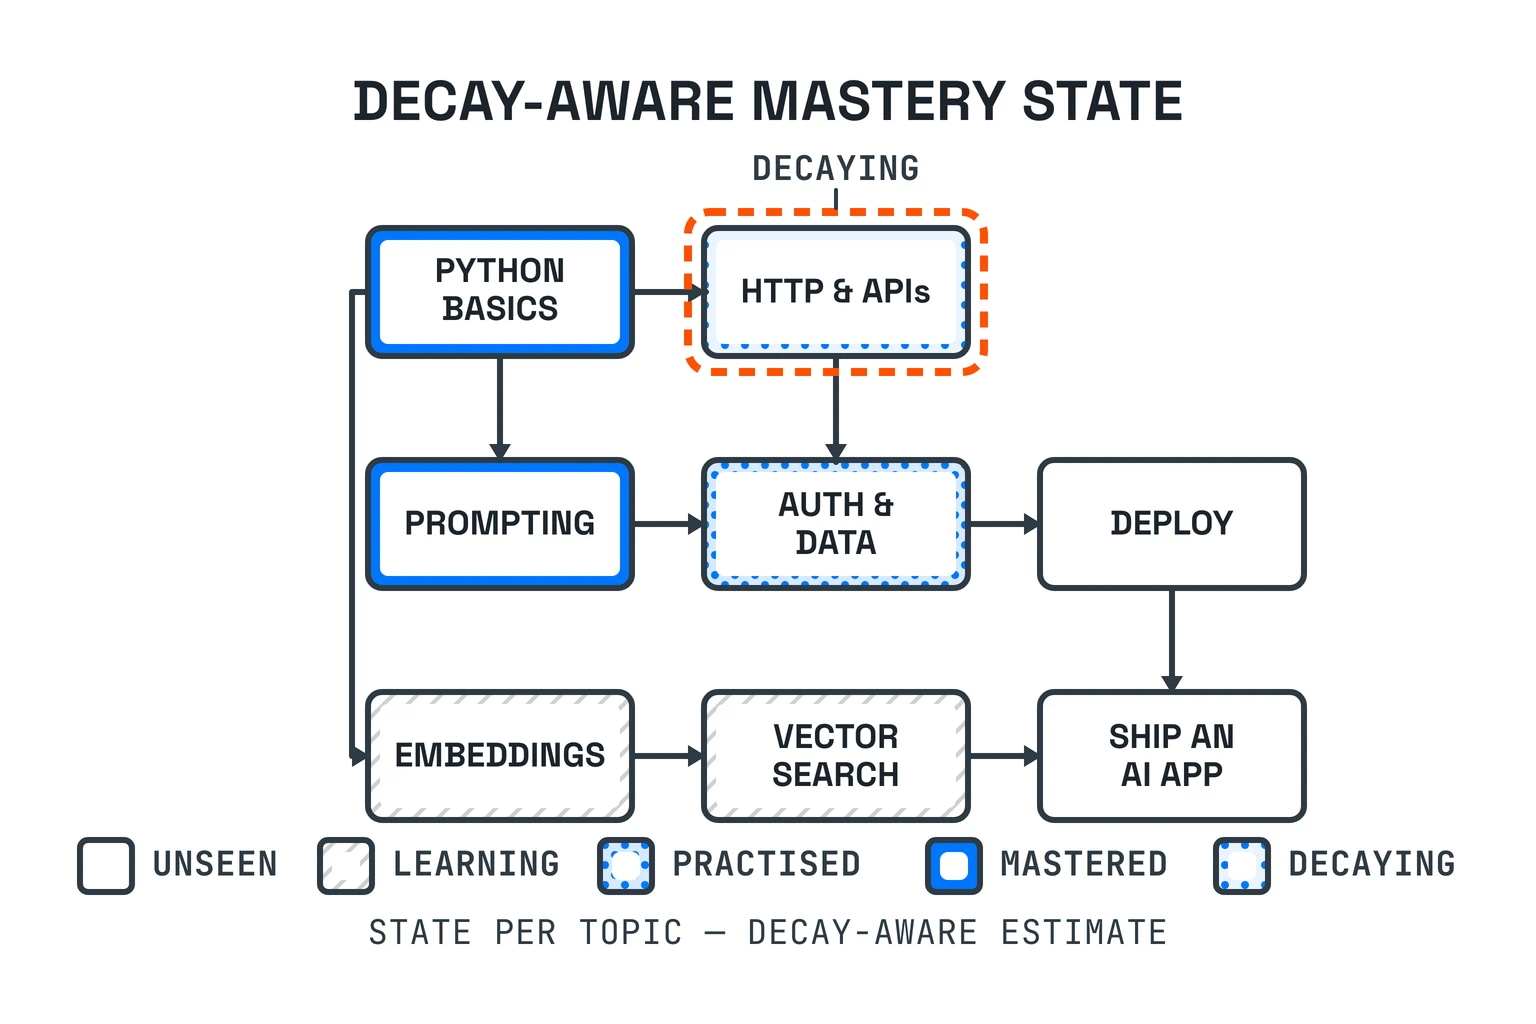
提案中のアプリ表示では、各トピックに見える状態を割り当て、習熟度を恒久的なものとして示すのではなく、古くなったエビデンスを薄く表示します。この状態は、成績と時間から導く推定値であり、知識を直接観察したものではありません。
実践者の四段階ラダーでは、無意識的無能、意識的無能、意識的有能、無意識的有能というラベルを使います。Gordon Training Internationalはこの段階をNoel Burchによるものとしていますが、ここで利用できる出典は原文書ではなく2016年の組織による回顧です。そのため、このラダーは振り返りのための語彙としてのみ扱います。
1980年のDreyfus報告書は、初心者、能力、熟達、専門性、達人という段階を挙げ、スキルが発達するにつれて、実践者は抽象的な規則への依存を減らし、具体的な経験により頼るようになると論じています。著者らは、記述的エビデンスに対照実験のような客観性が欠けている可能性を認めています。また、後年の臨床レビューは、このモデルが臨床上の問題解決に適合するかを疑問視しましたが、あらゆる場面で成り立たないと主張したわけではありません。
改訂版Bloomタキソノミーは、目標を二つの次元で分類する枠組みです。認知過程の分類は、記憶する、理解する、応用する、分析する、評価する、創造する、で構成されます。緩やかな階層では重なりも認められており、これらは学習者を順に測る六段階の指標ではありません。
知識トレーシングは、チューターモデル内の各ルールを学習済みである確率の推定値を保持します。元のモデルでは、ルールごとに事前習得、習得、推測、スリップという四つのパラメータを使い、忘却がないことを明示的に仮定しています。
必須演習の345個の目標を対象とした一つの検証では、予測された平均誤答率と実際の平均誤答率の相関は.75、平均絶対予測誤差は.07でした。同じ群に再適合すると相関は.90に上がりましたが、著者らはこれを標本外の予測精度ではなく上限として説明しています。
半減期回帰は、練習からの経過時間と推定された記憶の半減期から再生確率をモデル化することで、減衰を加えます。この半減期は仮説上のモデル構成概念であり、観測された量ではありません。
Duolingoの学生と単語の組み合わせ1,290万件の履歴では、主要な二つのモデル変種が再生予測の平均絶対誤差.128に達し、Leitner方式の.235から少なくとも45%減少しました。これは、あるプロダクトのノイズを含み範囲が限定されたデータに対する予測誤差であり、測定された学習成果ではありません。
学生330万人を対象にした2週間の実験では、一つのモデル変種によって、翌日の活動、レッスン継続、練習継続がそれぞれ12.0%、1.7%、9.5%増えました。これは二つのモデル変種を比較したプロダクト・エンゲージメント指標であり、学習の伸びではありません。
エビデンスが学習アプリに意味すること
この調査から得られたのは、五つのプロダクト成果ではなく、五つの設計原則です。
- まずマップを作る。 前提関係と目標に関連する経路を表し、専門家の判断だけでなく学習者のデータで構造を検証します。
- レイヤーに分けて学ぶ。 中心概念、重要な詳細、細かな詳細を整理の順序として使い、このパッケージが未測定であることを明示します。
- テストしてから進む。 学習者に内容を思い出すか応用してもらい、抜けを診断して修正学習を用意し、一度の即時的な成功を恒久的な習熟として扱いません。
- 復習に間隔を空ける。 一律の間隔を押し付けず、保持目標、前回学習からの経過、観測された成績に基づいて次の試行を予定します。
- 減衰を考慮した状態を誠実に示す。 不確実性を伴うトピックごとの推定値を表示し、エビデンスが古くなるにつれて薄くします。
アプリはまだ作られていないため、各原則はプロダクト成果ではなく、検証すべき設計判断です。
今週、どの有用性評価の低い学習法をやめますか?
出典
- Dunlosky, John; Rawson, Katherine A.; Marsh, Elizabeth J.; Nathan, Mitchell J.; Willingham, Daniel T. “Improving Students’ Learning With Effective Learning Techniques: Promising Directions From Cognitive and Educational Psychology.” Psychological Science in the Public Interest / SAGE Publications, 2013. https://www.whz.de/fileadmin/lehre/hochschuldidaktik/docs/dunloskiimprovingstudentlearning.pdf. Accessed 2026-08-23.
- Roediger, Henry L. III; Karpicke, Jeffrey D. “Test-Enhanced Learning: Taking Memory Tests Improves Long-Term Retention.” Psychological Science / SAGE Publications, 2006. https://colinallen.dnsalias.org/Readings/2006_Roediger_Karpicke_PsychSci.pdf. Accessed 2026-08-23.
- Cepeda, Nicholas J.; Pashler, Harold; Vul, Edward; Wixted, John T.; Rohrer, Doug. “Distributed practice in verbal recall tasks: A review and quantitative synthesis.” Psychological Bulletin / American Psychological Association, 2006. https://augmentingcognition.com/assets/Cepeda2006.pdf. Accessed 2026-08-23.
- Murre, Jaap M. J.; Dros, Joeri. “Replication and Analysis of Ebbinghaus’ Forgetting Curve.” PLOS ONE / Public Library of Science, 2015. https://journals.plos.org/plosone/article?id=10.1371/journal.pone.0120644. Accessed 2026-08-23.
- Rohrer, Doug; Taylor, Kelli. “The shuffling of mathematics problems improves learning.” Instructional Science / Springer Netherlands, 2007. https://link.springer.com/article/10.1007/s11251-007-9015-8. Publisher summary only. Accessed 2026-08-23.
- Keshav, S. “How to Read a Paper.” ACM SIGCOMM Computer Communication Review, 2007. http://ccr.sigcomm.org/online/files/p83-keshavA.pdf. Accessed 2026-08-23.
- Kazu, İbrahim Yaşar; Kaplan, Aslan. “The Effect of Layered Curriculum on Academic Achievement: A Meta-Analysis Study.” Turkish Online Journal of Educational Technology, 2025. https://files.eric.ed.gov/fulltext/EJ1478427.pdf. Accessed 2026-08-23.
- Luiten, John; Ames, Wilbur; Ackerson, Gary. “A Meta-analysis of the Effects of Advance Organizers on Learning and Retention.” American Educational Research Journal, 1980. https://eric.ed.gov/?id=EJ233231. Abstract only. Accessed 2026-08-23.
- Sana, Faria; Forrin, Noah D.; Sharma, Mrinalini; Dubljevic, Tamara; Ho, Peter; Jalil, Ezza; Kim, Joseph A. “Optimizing the Efficacy of Learning Objectives through Pretests.” CBE—Life Sciences Education, 2020. https://pmc.ncbi.nlm.nih.gov/articles/PMC8711814/. Accessed 2026-08-23.
- Nestojko, John F.; Bui, Dung C.; Kornell, Nate; Bjork, Elizabeth Ligon. “Expecting to teach enhances learning and organization of knowledge in free recall of text passages.” Memory & Cognition, 2014. https://link.springer.com/article/10.3758/s13421-014-0416-z. Accessed 2026-08-23.
- Ericsson, K. Anders; Krampe, Ralf T.; Tesch-Römer, Clemens. “The Role of Deliberate Practice in the Acquisition of Expert Performance.” Psychological Review, 1993. https://graphics8.nytimes.com/images/blogs/freakonomics/pdf/DeliberatePractice(PsychologicalReview).pdf. Accessed 2026-08-23.
- Macnamara, Brooke N.; Hambrick, David Z.; Oswald, Frederick L. “Deliberate practice and performance in music, games, sports, education, and professions: a meta-analysis.” Psychological Science, 2014. https://pubmed.ncbi.nlm.nih.gov/24986855/. Abstract only. Accessed 2026-08-23.
- Bloom, Benjamin S. “Learning for Mastery.” Evaluation Comment / Regional Education Laboratory for the Carolinas and Virginia, 1968. https://archive.org/download/ed-053419/ED053419_djvu.txt. Accessed 2026-08-23.
- Bloom, Benjamin S. “The 2 Sigma Problem: The Search for Methods of Group Instruction as Effective as One-to-One Tutoring.” Educational Researcher, 1984. https://gwern.net/doc/psychology/1984-bloom.pdf. Accessed 2026-08-23.
- Nickow, Andre; Oreopoulos, Philip; Quan, Vincent. “The Promise of Tutoring for PreK–12 Learning: A Systematic Review and Meta-Analysis of the Experimental Evidence.” American Educational Research Journal, 2024. https://eric.ed.gov/?id=EJ1406037. Abstract only. Accessed 2026-08-23.
- Kulik, Chen-Lin C.; Kulik, James A.; Bangert-Drowns, Robert L. “Effectiveness of Mastery Learning Programs: A Meta-Analysis.” Review of Educational Research, 1990. https://api.crossref.org/works/10.3102/00346543060002265. Abstract only. Accessed 2026-08-23.
- Novak, Joseph D.; Cañas, Alberto J. “The Theory Underlying Concept Maps and How to Construct and Use Them.” Florida Institute for Human and Machine Cognition, revised 2008. https://cmap.ihmc.us/publications/researchpapers/theoryunderlyingconceptmaps.pdf. Accessed 2026-08-23.
- Nesbit, John C.; Adesope, Olusola O. “Learning With Concept and Knowledge Maps: A Meta-Analysis.” Review of Educational Research, 2006. http://www.sfu.ca/~jcnesbit/articles/nesbitadesope2006.htm. Abstract only. Accessed 2026-08-23.
- Doignon, Jean-Paul; Falmagne, Jean-Claude. “Spaces for the assessment of knowledge.” International Journal of Man-Machine Studies / Elsevier, 1985. https://linkinghub.elsevier.com/retrieve/pii/S0020737385800316. Abstract only. Accessed 2026-08-23.
- Falmagne, Jean-Claude; Cosyn, Eric; Doignon, Jean-Paul; Thiéry, Nicolas. “The Assessment of Knowledge, in Theory and in Practice.” Formal Concept Analysis / Springer, 2006. https://www.aleks.com/about_aleks/Science_Behind_ALEKS.pdf. Accessed 2026-08-23.
- Pavlich-Mariscal, Jaime A.; Curiel, Mariela; Chavarro, German. “CDIO Curriculum Design for Computing: A Graph-Based Approach.” Proceedings of the 15th International CDIO Conference, 2019. https://cdio.org/files/document/file/81.pdf. Accessed 2026-08-23.
- Montgomery, Denise. “The Four Stages of Learning: They’re a Circle, Not a Straight Line.” Gordon Training International, 2016. https://www.gordontraining.com/leadership/four-stages-learning-theyre-circle-not-straight-line/. Accessed 2026-08-23.
- Dreyfus, Stuart E.; Dreyfus, Hubert L. “A Five-Stage Model of the Mental Activities Involved in Directed Skill Acquisition.” Operations Research Center, University of California, Berkeley, 1980. https://archive.org/details/DTIC_ADA084551. Accessed 2026-08-23.
- Peña, Adolfo. “The Dreyfus model of clinical problem-solving skills acquisition: a critical perspective.” Medical Education Online, 2010. https://pmc.ncbi.nlm.nih.gov/articles/PMC2887319/. Accessed 2026-08-23.
- Krathwohl, David R. “A Revision of Bloom’s Taxonomy: An Overview.” Theory Into Practice / Taylor & Francis, 2002. https://centreforfacdev.ca/pdf/TLC%20Resources/A%20Revision%20of%20Bloom_s%20Taxonomy%20-%20An%20Overview.pdf. Accessed 2026-08-23.
- Corbett, Albert T.; Anderson, John R. “Knowledge tracing: Modeling the acquisition of procedural knowledge.” User Modeling and User-Adapted Interaction / Kluwer Academic Publishers, 1995. https://act-r.psy.cmu.edu/wordpress/wp-content/uploads/2012/12/893CorbettAnderson1995.pdf. Accessed 2026-08-23.
- Settles, Burr; Meeder, Brendan. “A Trainable Spaced Repetition Model for Language Learning.” Proceedings of the 54th Annual Meeting of the Association for Computational Linguistics, 2016. https://aclanthology.org/P16-1174/. Accessed 2026-08-23.