
学習するゲノム編集者:モデルはランダムより上手くNEATを変異させられるか
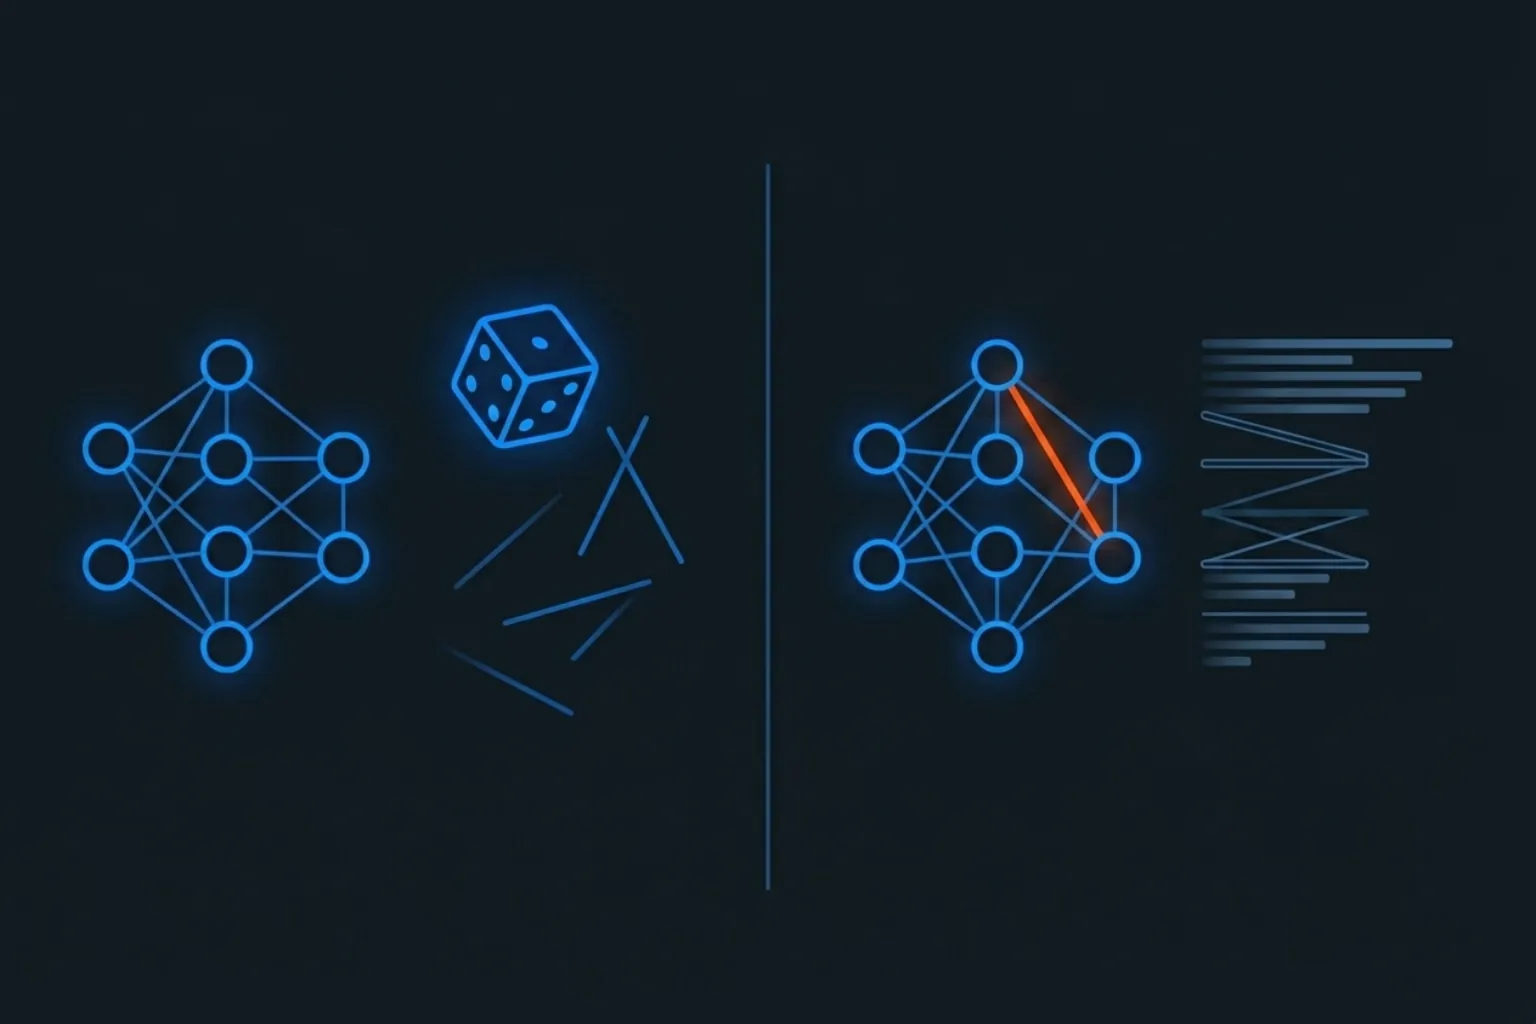
有用な接続と役に立たない接続が、比較基準のNEATではまったく同じ確率で選ばれます。ノード追加(add-node)——既存の接続を新しいノードで分割する構造変異——または接続追加(add-connection)——既存の二つのノードを結ぶ変異——が発動すると、比較基準はその演算子の合法な候補から一様に選びます。見込みのある編集も行き止まりの編集も、同じ抽選で消えかねません。
どのゲノムが生き残るかは、すでに適応度が決めています。前回の意思決定記録ではゲノム評価の内側に学習を置きましたが、今回の実験では、はるかに小さな学習器を一段前の変異決定に置きます。最初のAI制作記録は進化だけを使う比較基準であり、この実験で変える比較基準はSkyline RunのAIラボで動いています。
対応する実行はまだ行っていません。以下の実験値はすべて測定値ではなく選んだ値です。結果が出る前に比較方法を固定します。
このサイトとAI Maker Labチャンネルは私が所有し、制作しています。これは制作記録であり、第三者による独立したレビューではありません。
過去の編集は公平な抽選に勝てるか
過去の親子の結果で訓練したモデルは、NEATの残りの部分を置き換えずに、一様サンプリングより優れた構造変異を選べるでしょうか。
表現はNEATのままです。種分化とは、似たゲノムをまとめ、新参者が同類とのみ競えるようにする仕組みで、引き続き構造上の新規性を保護します。交叉では、遺伝子が初めて現れた時点を示す全体共通の識別子であるイノベーション番号を使い、二つのゲノムを揃えます。変えるのは二つの選択だけです。ノード追加変異でどの有効な接続を分割するかと、接続追加変異でどの合法なノードの組を接続するかです。
重みの変異はランダムのままです。この範囲の境界は意図的に設けています。構造変異と重み変異を同時に変えれば、差が生じても構造編集の選択によるものか判別できなくなるからです。
先行研究は可能性を示すが、勝利までは示さない
Lehman、Stanleyらの「Evolution through Large Models」は、学習済みモデルを突然変異演算子として使えることを示しています。 ELMは言語モデルによる差分提案をMAP-Elites——一つの全体最良だけでなく、行動の格子の各セルに最良解を残す手法——の内側に置き、マップに受け入れられた子個体で差分モデルを微調整しました。その循環により、進化の履歴が後の提案を改善しました。この方式が確立されたのはPythonプログラムとSodaraceの生成物についてであり、LLMや他の学習型編集器が離散的なNEATグラフ編集を順位付けできることまでは確立していません。
Romera-ParedesらのFunSearchは、モデルが提案するプログラム変異が実際の数学的発見につながり得ることを示しています。 FunSearchは事前訓練済み言語モデルと評価器を組み合わせ、それまでの最良記録を超えるキャップ集合の構成を発見しました。生成したプログラムと厳密な評価の組み合わせが実質的な探索結果を生み出せることは確立しましたが、この実験のNEAT変異からモデルが学習したことや、小さなスコアラーが一様選択を上回ることは示していません。
Langeらの「Discovering Evolution Strategies via Meta-Black-Box Optimization」は、言語モデルを使わずに演算子を学習する最も近い先例です。 メタ学習した自己注意ベースの探索戦略は、訓練に使った問題や最適化設定を越えて汎化しました。進化戦略の更新則自体を学習できることは確立しましたが、有用なNEAT編集を特定するものではありません。この限定的な先例があるため、今回の実験では言語モデルではなく小さなニューラルスコアラーを選びます。
HansenとOstermeierによるCMAの研究が示すように、突然変異分布の適応は新しい発想ではありません。 共分散行列適応は、選択された探索ステップを使って、後続する連続変異の分布を適応させます。連続正規変異分布の自己適応は確立しましたが、グラフ編集という離散的な選択は解決しません。この実験ではその選択を変え、NEATの重み変異はそのままにします。
Realらの「Regularized Evolution for Image Classifier Architecture Search」は、学習型コントローラーが必ず勝つと仮定してはならないという警告です。 制御されたアーキテクチャ探索の比較では、正則化進化が、ZophとLeが導入した学習型強化学習コントローラーの系譜に匹敵する結果へ到達しながら、単純な探索手法であり続けました。異なるアーキテクチャ空間では、素朴な進化的探索が、より学習を取り入れた提案機構に匹敵し得ることを確立した研究です。今回の比較結果を予測するものではないため、帰無結果となる経路も事前に登録します。
StanleyとMiikkulainenのNEATは、編集後のゲノムを比較可能に保ち、多様性を保護する表現を提供します。 イノベーション番号は交叉時に相同遺伝子を揃え、種分化は新しい構造が試されるまで保護します。この仕組みは、可変トポロジーのゲノムを交叉可能かつ多様に保つ方法を確立していますが、訓練済みスコアラーがより優れた変異を選ぶことまでは確立していません。
編集器を裁く前に比較基準を固定する
実験には、選んだ最小限のフィードフォワードNEAT設定を使います。この設計の値はすべて、最初の実行より前に固定します。
選んだ個体数は150です。選んだ互換性係数はc1 = 1.0、c2 = 1.0、c3 = 0.4、選んだ互換性閾値は3.0です。選んだ停滞上限は15世代です。
各子個体が受ける構造編集は、選んだ上限1回までです。これは標準的なNEATから意図的に変えた点です。一度の誕生で複数の構造編集を許すと、候補への貢献度割り当てが曖昧になります。選んだノード追加確率は0.03、選んだ接続追加確率は0.05です。
選んだタスクは、上限200世代のXORと、3ビットパリティ(上限400世代)です。各比較群には、タスクごとに選んだ30個のシードを割り当てます。これらは評価上限と標本数であり、観測した実行長や結果ではありません。
スコアラーが見るのは構造、履歴、性能
スコアラーが合法な編集同士を見分けられるように、各候補を選んだ13特徴量のベクトルにします。
- 編集の構造: 編集種別フラグ、始点の深さ、終点の深さ、深さの差、始点の入次数、始点の出次数、終点の入次数、終点の出次数、共通祖先フラグ。
- ゲノムの文脈: 総ノード数、有効な接続数。
- 親の履歴と性能: 種内での親の適応度パーセンタイル、親の年齢。
接続分割の候補では、始点と終点はその接続の両端を指します。適用できない特徴量には、設計上ゼロを入れます。
スコアラーは、形状13 -> 32 tanh -> 1の、選んだNumPy多層パーセプトロンです。模倣ラベルは厳密にchild fitness > parent fitnessとします。収集ラベルに含めるのは、評価済みの一つの親個体からクローンした無性生殖の子個体に、その後一回の構造編集を施した場合だけです。記録には、その子個体が親を上回ったかどうかを残します。交叉で生じた子個体は通常の進化に残しますが、スコアラーの訓練記録には含めません。この制限により親子比較が曖昧にならず、交叉に突然変異の貢献度が割り当てられることを防ぎます。このラベルは有用な編集を表す代理指標であり、長期的な進化価値を捉えるという主張ではありません。
訓練データは、選んだ一様ランダムな比較基準の収集実行をタスクごとに30回、合計60回行って得ます。XORと3ビットパリティは、それぞれ別のスコアラーを訓練します。各タスク内で、訓練と検証の分割は、変異記録単位ではなく必ず実行単位で行います。同じ実行の子孫やほぼ同一のゲノムが分割をまたいで漏れることを防ぐためです。
進化中は、固定したネットワークが合法な編集候補をすべて採点します。ソフトマックス温度とイプシロンは、選択に残すランダム性の量を決めます。選んだ方策は、温度0.5でスコアにソフトマックスを適用してサンプリングし、選んだイプシロン0.2の確率では一様サンプリングへ戻ります。
この方策は、二つの失敗要因を考慮して定めています。探索の崩壊が起きると、初期の選好により、まだ価値を観測していない編集が抑制されます。そのためイプシロンとNEATの種分化を循環に残します。分布シフトが起きると、進化は比較基準の履歴とは異なるゲノムへ移ります。そのため比較中はスコアラーを固定します。オンライン再訓練は、評価中に演算子そのものを変えてしまうため、この最初の試行では意図的に範囲外とします。
新しいシードだけが編集器の勝敗を決める
ランダムな比較基準と学習型編集器の群には、同じ評価予算を割り当てます。収集用シードと比較用シードは分け、スコアラーの訓練データを生成したシードを比較実行で再利用できないようにします。
主要指標は、最初の解までに要した評価回数です。解けなかった実行は、選んだタスク上限で打ち切りとして扱います。登録する推論は、ラベルを入れ替えて偶然が結果を上回る頻度を調べる両側置換検定で、選んだ10 000回の再標本化により中央値の差を検定します。スコアラーのホールドアウト集合におけるAUC——ROC曲線下面積で、0.5なら偶然の順位付け、1なら完全な順位付け——は、その順位付けに信号が含まれるかを示す別の診断指標として報告します。
各タスクの方向付き成功条件は、学習型編集器群の「最初の解までに要した評価回数」の中央値が低いことです。上記の両側置換検定によるp値をタスクごとに計算します。次に、複数の仮説を同時に検定するとき各閾値を厳しくするホルム補正を、二つのp値へファミリーワイズ有意水準——二つのタスク全体で少なくとも一つの偽陽性を出す確率の上限——0.05で適用します。タスク単位の根拠とするには、中央値が低いこととホルム補正後の有意性の両方が必要です。
この手順では、各主張を、それを支えられる検定に結び付けます。
| タスク | 検定 | 合格基準 |
|---|---|---|
| XOR | 最初の解までに要した評価回数の中央値差に対する両側置換検定 | 学習型編集器の中央値が低く、ホルム補正後も有意 |
| 3ビットパリティ | 最初の解までに要した評価回数の中央値差に対する両側置換検定 | 学習型編集器の中央値が低く、ホルム補正後も有意 |
| 一般仮説 | 両タスクの結果 | 両タスクがタスク単位の条件を満たす |
一般仮説を支持されたと判断するのは、両方のタスクがこの条件を満たした場合だけです。一つのタスクだけに根拠がある場合は、そのタスク固有の結果として報告し、一般的な根拠とはしません。どちらも条件を満たさなければ帰無結果、方向が逆転すれば否定的な結果です。
編集器の根拠とするには、訓練履歴を生成したシードで優位性を再現するのではなく、新しい比較用シードで一様な比較基準を上回る必要があります。ホールドアウト集合でAUCが高くても、新しいシードで進化上の優位性がなければ、演算子の勝利とはみなしません。
結果が出るまで、優位性は主張できない
何も測定していません。比較基準の収集実行、スコアラーの訓練実行、比較実行はいずれもまだ行っておらず、この記事は編集器の優位性を主張しません。
手作業で設計した特徴量には有用な信号がない可能性があり、その場合、ホールドアウト集合でのAUCは0.5付近にとどまるかもしれません。XORは簡単すぎて、選んだ上限内ではどちらの演算子にも差が出ない可能性があります。また、構造編集を一回に制限する規則があるため、比較基準はここで定めたNEATの変種であり、発表済みの標準アルゴリズムではありません。帰無結果、逆転、結論の出ない比較は、いずれもこの手順で有効な結果です。
決めたのは比較方法であり、結果ではありません。実行後には、ホールドアウト集合でのAUC、新しい比較用シードにおける各群の「最初の解までに要した評価回数」の中央値、両タスクのホルム補正後のp値を掲載します。それまでは、記憶の罠:チャンピオンが一つの地区だけを覚えたときが、強いスコアにも間違った学習が隠れ得るという警告になります。
出典
- Lehman, Joel; Gordon, Jonathan; Jain, Shawn; Ndousse, Kamal; Yeh, Cathy; Stanley, Kenneth O. “Evolution through Large Models.” arXiv:2206.08896, 2022. https://arxiv.org/abs/2206.08896. Accessed 2026-08-21.
- Romera-Paredes, Bernardino; Barekatain, Mohammadamin; Novikov, Alexander; Balog, Matej; Kumar, M. Pawan; Dupont, Emilien; Ruiz, Francisco J. R.; Ellenberg, Jordan S.; Wang, Pengming; Fawzi, Omar; Kohli, Pushmeet; Fawzi, Alhussein. “Mathematical Discoveries from Program Search with Large Language Models.” Nature, published online 2023; 625:468–475, 2024. https://doi.org/10.1038/s41586-023-06924-6. Accessed 2026-08-21.
- Lange, Robert Tjarko; Schaul, Tom; Chen, Yutian; Zahavy, Tom; Dallibard, Valentin; Lu, Chris; Singh, Satinder; Flennerhag, Sebastian. “Discovering Evolution Strategies via Meta-Black-Box Optimization.” arXiv:2211.11260, 2022. https://arxiv.org/abs/2211.11260. Accessed 2026-08-21.
- Hansen, Nikolaus; Ostermeier, Andreas. “Completely Derandomized Self-Adaptation in Evolution Strategies.” Evolutionary Computation 9(2):159–195, 2001. https://doi.org/10.1162/106365601750190398. Accessed 2026-08-21.
- Real, Esteban; Aggarwal, Alok; Huang, Yanping; Le, Quoc V. “Regularized Evolution for Image Classifier Architecture Search.” arXiv:1802.01548, 2018. https://arxiv.org/abs/1802.01548. Accessed 2026-08-21.
- Zoph, Barret; Le, Quoc V. “Neural Architecture Search with Reinforcement Learning.” arXiv:1611.01578, 2016. https://arxiv.org/abs/1611.01578. Accessed 2026-08-21.
- Stanley, Kenneth O.; Miikkulainen, Risto. “Evolving Neural Networks through Augmenting Topologies.” Evolutionary Computation 10(2):99–127, 2002. https://doi.org/10.1162/106365602320169811. Accessed 2026-08-21.
このサイトとAI Maker Labチャンネルは私が所有し、制作しています。これは制作記録であり、第三者による独立したレビューではありません。