
MiniMax Music 3: 17 trilhas que eu não vou usar
Gerei localmente 17 trilhas instrumentais com MiniMax Music 3 no ComfyUI, em um Apple M1 Max, e, pela minha própria conta aproximada, gastei mais de 25 horas nesse lote.
Eu sou dono e desenvolvo este site e o canal AI Maker Lab — este é um registro de desenvolvimento, não uma análise independente.
Minha conclusão é que este lote de 17 trilhas não passou pelo meu próprio teste de gosto, embora tenha usado Structured Captions de três partes; na segunda tentativa, vou testar uma variável por vez em rascunhos de 30 segundos antes da renderização longa.
O que eu criei: 17 trilhas instrumentais locais
O lote reúne 17 trilhas instrumentais originais: cinco dimensionadas para Reels ou Stories do Instagram e doze para episódios do YouTube. Rodei o MiniMax Music 3 pelo ComfyUI em um Apple M1 Max com 64 GB de memória unificada. Essa máquina usou os pesos DiT fp16, o codificador de texto bf16 reduzido e o DAV VAE. Cada faixa também recebeu um Structured Caption de três partes, um bloco Vocal Details instrumental e um Arrangement com marcações de tempo.
A biblioteca registra estilo, andamento, tonalidade, duração entregue e uso pretendido para cada faixa. Esses campos descrevem o pedido, não uma análise musical verificada do áudio gerado. O model card explica que andamento, tonalidade, instrumentação e estrutura são controles generativos, não garantias; por isso, a escuta continua sendo a verificação. Os masters WAV permanecem em 44,1 kHz e 16 bits, enquanto os players abaixo usam cópias MP3 medidas com as mesmas durações.
Na minha avaliação, nenhuma dessas 17 faixas ficou boa o suficiente para eu manter no canal. Esse veredito vale somente para este lote e para o meu gosto. Ele não compara modelos nem avalia o MiniMax Music 3 de forma geral. A regra da própria biblioteca também exige ouvir cada trilha sob a narração real, não apenas isoladamente.
Ouça as 17 trilhas
As 17 trilhas entregues aparecem aqui como cópias MP3. Cada cópia foi codificada do WAV de entrega registrado, e a duração medida coincidiu exatamente com o ledger. Estilo, andamento, tonalidade, duração e uso vêm desse registro interno; andamento e tonalidade continuam sendo alvos pedidos que exigem escuta.
A licença do MiniMax-Music3 exige que conteúdo público informe, de modo claro e destacado, que foi gerado por máquina. A linha a seguir é a redação escolhida neste repositório, não uma frase prescrita pela licença: Music generated with MiniMax-Music3.
Cinco trilhas para Instagram
Doze trilhas para YouTube
Onde gastei mais de 25 horas — segundo meu próprio relato
Pela minha própria conta aproximada, gastei mais de 25 horas nesse lote. Esse total é um relato pessoal, não uma soma reconstruída dos logs da máquina. A única medição de tempo de execução aqui cobre dois rascunhos de 30 segundos neste M1 Max. Eles levaram 40 minutos e 46 segundos e 38 minutos e 44 segundos, cerca de 80 segundos de tempo de máquina para cada segundo de áudio neste computador.
Esse custo medido torna importante a ordem dos testes, sem provar qualquer ganho de produtividade. O procedimento local começa com um rascunho de 30 segundos. Mantenha a seed fixa enquanto muda um eixo do caption, como andamento, paleta ou perfil de produção. Depois, congele o caption, rode duas ou três seeds e compare as performances pela escuta. Envie uma seed escolhida para a renderização longa e configure a duração desejada mais cerca de dez segundos, pois a geração pode terminar antes.
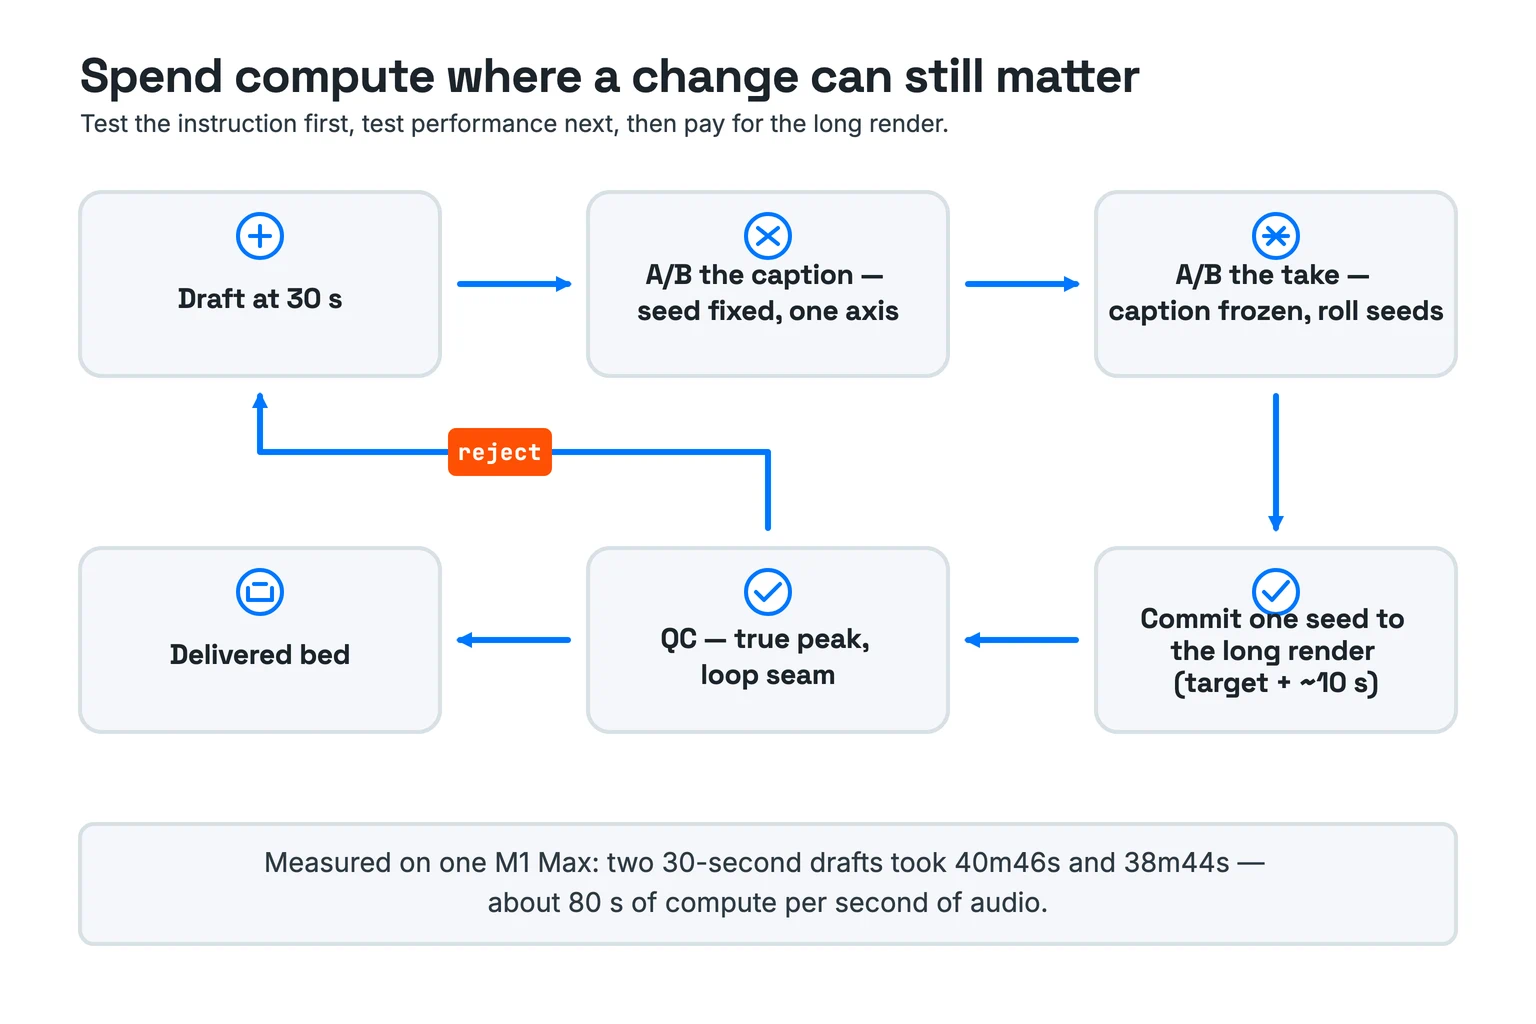
O ciclo inclui um caminho real de rejeição. O controle de qualidade verifica o true peak e a emenda do loop antes da entrega, e devolve uma trilha rejeitada ao rascunho. Esse filtro de gosto não é o mesmo que concluir um arquivo. Uma renderização reproduzível ainda pode falhar na minha decisão sobre usar a música no canal.
O fluxo de trabalho que a pesquisa indicava
O fluxo pesquisado forma uma cadeia: escrever um caption disciplinado, testar uma variável, ouvir os alvos flexíveis, desenhar a emenda e verificar o nível entregue. A estrutura correta do caption não garante que eu goste do resultado. O anúncio oficial descreve Structured Captions como descrições temporais de emoção, instrumentação, vozes e arranjo. Meu lote mostra apenas que conformidade estrutural e aceitação pessoal são filtros diferentes.
Escreva um Structured Caption de três partes
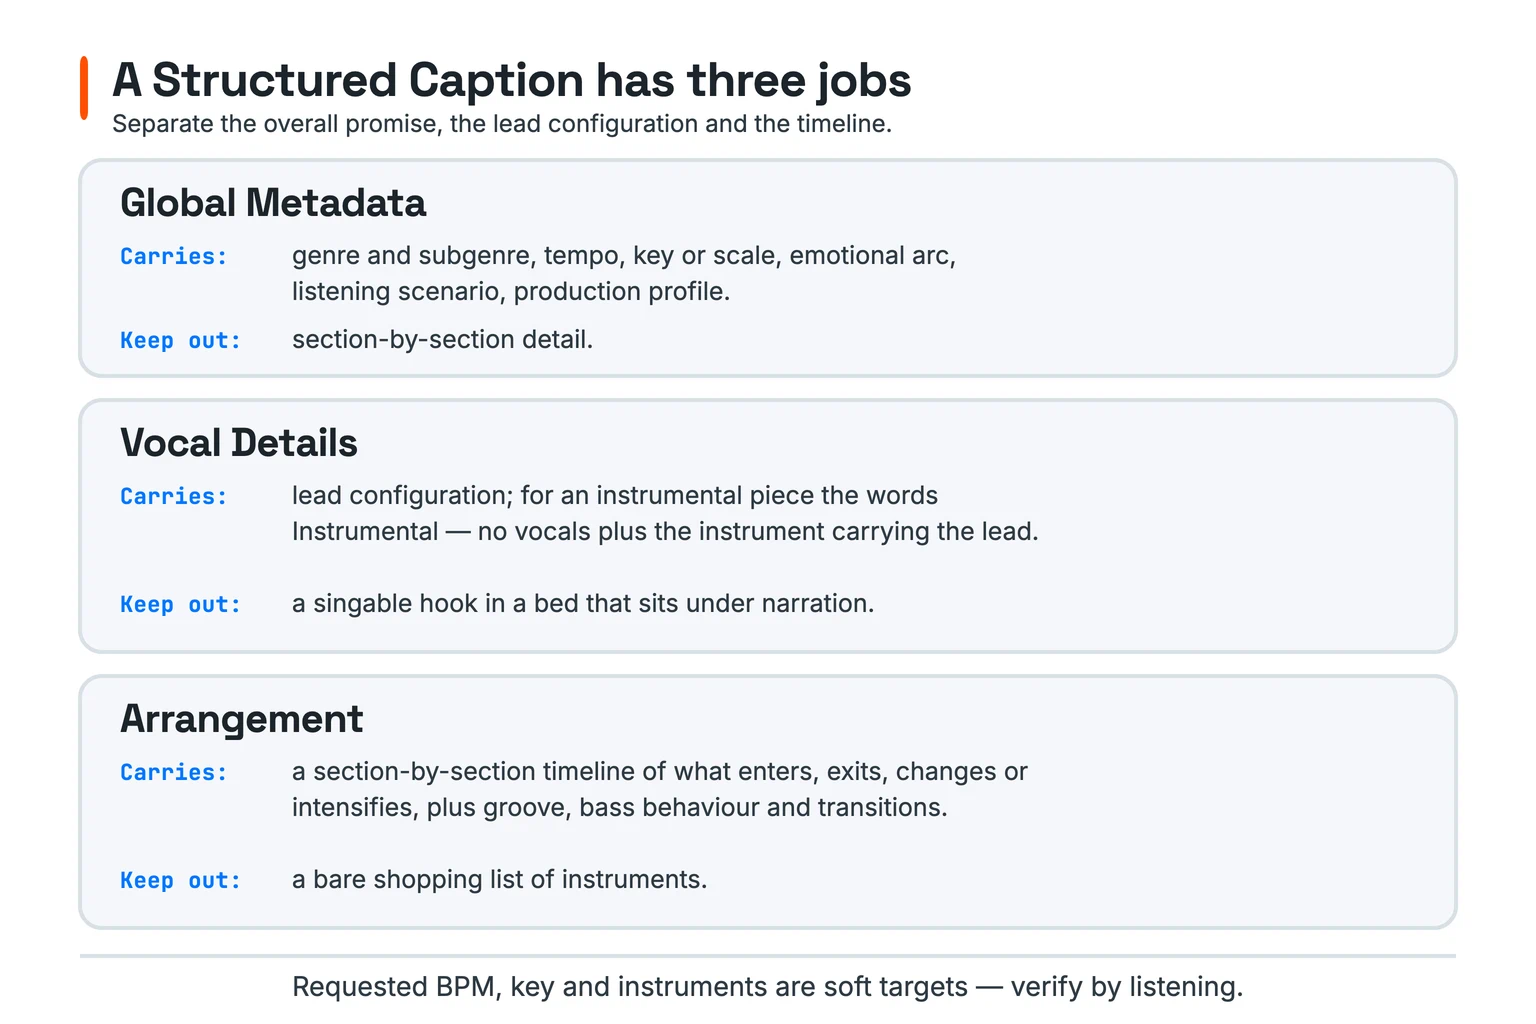
O model card da MiniMax recomenda três partes para controle preciso: Global Metadata, Vocal Details e Arrangement. Global Metadata carrega gênero, andamento, tonalidade, arco emocional, cenário e perfil de produção. Vocal Details define a configuração principal; uma trilha instrumental declara Instrumental — no vocals e nomeia o instrumento principal. Arrangement descreve quando instrumentos entram, mudam, ganham intensidade e saem em seções nomeadas.
A prática local busca cerca de 250 a 450 palavras em inglês. Abaixo de aproximadamente 120 palavras, o modelo tendeu a associar livremente; depois de cerca de 600, tendeu a ignorar o final. Essas faixas são observações locais, enquanto o model card informa o teto oficial de 5.000 tokens. O guia oficial de prompts da MiniMax recomenda nomear com precisão dois ou três instrumentos e deixar o restante para o modelo. A prática local então dá um ciclo de vida a cada instrumento, em vez de manter uma lista estática.
Separe alvos flexíveis de instruções executáveis
BPM, tonalidade, instrumentos e estrutura pedidos são alvos flexíveis. O model card diz que eles oferecem controle generativo, não garantias simbólicas rígidas; portanto, cada um exige uma verificação pela escuta. As tags de seção são as instruções estruturais executáveis no fluxo local. O conjunto aceito inclui [Intro], [Verse], [Pre-Chorus], [Chorus], [Post-Chorus], [Bridge], [Instrumental], [Solo] e [Outro].
Para uma trilha instrumental, o esqueleto local usa [Intro], [Instrumental] e [Outro]. O Arrangement deve nomear essas seções para alinhar o caption ao esqueleto estrutural. Na prática local, uma tag [Chorus] perdida convidou o modelo a cantar. Esse é um alerta observado no fluxo, não uma promessa sobre toda geração.
Configure o grafo de nós do ComfyUI de forma deliberada
O tutorial oficial do ComfyUI descreve max_duration como duração-alvo e informa suporte a cerca de 300 segundos. O template do fluxo contém uma divergência: o widget ativo mostra 60, mas a própria nota diz que o padrão é 120. Nenhum deles deve virar um único padrão oficial sem ressalva. A geração também pode terminar antes do teto quando o modelo emite um token de fim do áudio.
Segundo o tutorial, uma seed fixa reproduz a mesma música, enquanto outra seed produz uma tomada diferente. Meu script local usou cfg_scale 1.7 e top_k 50, mas o tutorial e o template oficiais não explicam a semântica desses widgets. Posso registrar esses padrões locais sem inventar significados oficiais. Isso torna testes de uma variável mais honestos do que mudar vários controles juntos.
A decodificação VAE em tiles reduz o uso de memória, mas o tutorial aponta uma decodificação mais lenta e um pequeno risco de emendas. Ele recomenda desativar os tiles em GPUs com muita VRAM para obter a melhor qualidade. Neste fluxo no M1 Max, tiles de 1536 com sobreposição de 64 eram o padrão local para poupar memória. No Apple silicon, esta configuração usou DiT fp16 e codificador bf16 reduzido; a evidência local alerta para não usar no MPS as variantes int8_convrot, orientadas a CUDA.
Projete trilhas para narração e loops antes da entrega
Uma trilha para narração precisa abrir espaço para a fala antes da mixagem. A orientação local mantém 200 Hz–4 kHz pouco ocupados, remove o gancho melódico, sustenta um arco emocional plano e evita risers, impactos ou viradas com caixa gated. A regra da biblioteca exige testar cada trilha sob a narração real, não isoladamente. Como roteiros de Reels mudam entre inglês, português e japonês oferece o contexto adjacente de vídeo falado para esse uso.
Um loop exige trabalho de arranjo antes do crossfade. O caption deve terminar onde o arranjo começou. Em seguida, faça o crossfade da cauda com o início e ouça a emenda duas vezes. Se as pontas ocuparem lugares harmônicos diferentes, o procedimento local trata o caption como problema, em vez de alongar o crossfade.
Confira o true peak antes da entrega
Quinze das 17 tomadas brutas mediram acima de 0 dBTP, e a mais alta chegou a +1,130 dBTP; yt-rock-opener mediu exatamente 0,000 dBTP, enquanto ig-rock-launch mediu −0,310 dBTP. Dezesseis arquivos entregues foram atenuados para −1,200 dBTP; yt-boombap-city-night ficou em −1,400 dBTP. Essas medições descrevem apenas estes arquivos, não uma propriedade geral do MiniMax Music 3.
A orientação local para master de lançamento busca cerca de −14 LUFS integrados e true peak de no máximo −1 dBTP. Isso é prática da estação de trabalho, não uma exigência oficial da MiniMax ou de uma plataforma. A sequência importante é medir, aplicar o controle de nível planejado e verificar o resultado antes da entrega.
O que eu acho que deu errado — e o que vou mudar
Minha interpretação é limitada: o processo verificou arquivos e preservou entradas, mas não colocou cedo o bastante a minha decisão de gosto. Cada caption tinha as três partes exigidas, um bloco Vocal Details instrumental e um Arrangement temporizado. Mesmo assim, na minha avaliação, as faixas resultantes não ficaram boas o suficiente para eu manter. Um arquivo concluído e uma trilha aceita por mim são resultados diferentes.
Minha interpretação dos Structured Captions longos e prescritivos
Os captions também eram longos e muito prescritivos. Por exemplo, ig-rock-launch determinava seis seções temporizadas e proibia explicitamente risers, impactos, viradas com caixa gated, transições guiadas por pratos de ataque e floreios de tons. Eu interpreto essa densidade como um ponto a testar, não como causa demonstrada do meu veredito. Este lote não prova que captions detalhados geralmente geram música que alguém rejeitará.
A próxima distinção útil separa qualidade do caption e qualidade da tomada. Uma seed fixa permite comparar uma mudança de caption nas mesmas condições de tomada. Quando o caption sobrevive a esse teste, variar as seeds compara performances sem reescrever o briefing. A escuta fornece o filtro de gosto que estrutura e reprodutibilidade não conseguem fornecer.
Segunda tentativa: teste uma variável antes da renderização longa
Vou fazer uma segunda tentativa em breve. Vou começar com um rascunho de 30 segundos, manter a seed fixa e mudar um eixo do caption. Depois de congelar esse caption, vou rodar duas ou três seeds e escolher pela escuta. Só então vou enviar uma seed para a renderização longa com a duração desejada mais cerca de dez segundos.
A segunda tentativa é uma intenção declarada, não um resultado ou prazo prometido. Ela serve para tornar cada comparação interpretável. Não parto da suposição de que as próximas 17 faixas passarão pelo meu teste de gosto.
Fontes
- Model card do MiniMax-Music3 — partes do Structured Caption, tags, teto do prompt e limites dos alvos flexíveis.
- Anúncio oficial do MiniMax Music 3.0 — papel temporal dos captions e arranjos.
- Repositório oficial do MiniMax-Music3 — fluxo do modelo e referência do reescritor de captions.
- Tutorial oficial do MiniMax Music 3 no ComfyUI — grafo, duração, seed e decodificação em tiles.
- Template oficial do fluxo do ComfyUI — valores ativos e nota de parâmetros.
- Guia oficial de prompts para geração musical da MiniMax — escolha de instrumentos e redação do prompt.
- MiniMax-Music3 COMMUNITY LICENSE — dever de informar a geração por máquina em conteúdo público.
- Fontes internas:
content/bgm-library/ledger.tsv,content/bgm-library/README.md,content/bgm-library/LICENSE-NOTICE.mde ocaption.txtde cada faixa. - Referências operacionais locais:
minimax-music/references/prompting.md,bgm-for-video.md,local-inference.mdespotify-release.md.
Aplique a checagem de cinco linhas a um rascunho de 30 segundos
- Escreva Global Metadata com gênero, andamento, tonalidade, arco emocional, cenário e perfil de produção.
- Escreva Vocal Details ou declare
Instrumental — no vocalse nomeie o instrumento principal. - Ligue as mudanças do Arrangement às tags de seção usadas na entrada da geração.
- Nomeie dois ou três instrumentos com precisão e dê um ciclo de vida a cada um.
- Ouça os alvos flexíveis pedidos antes de enviar a seed escolhida para a renderização longa.