
Um genoma deve guardar o que sua rede aprendeu? Três formas de combinar gradientes e evolução
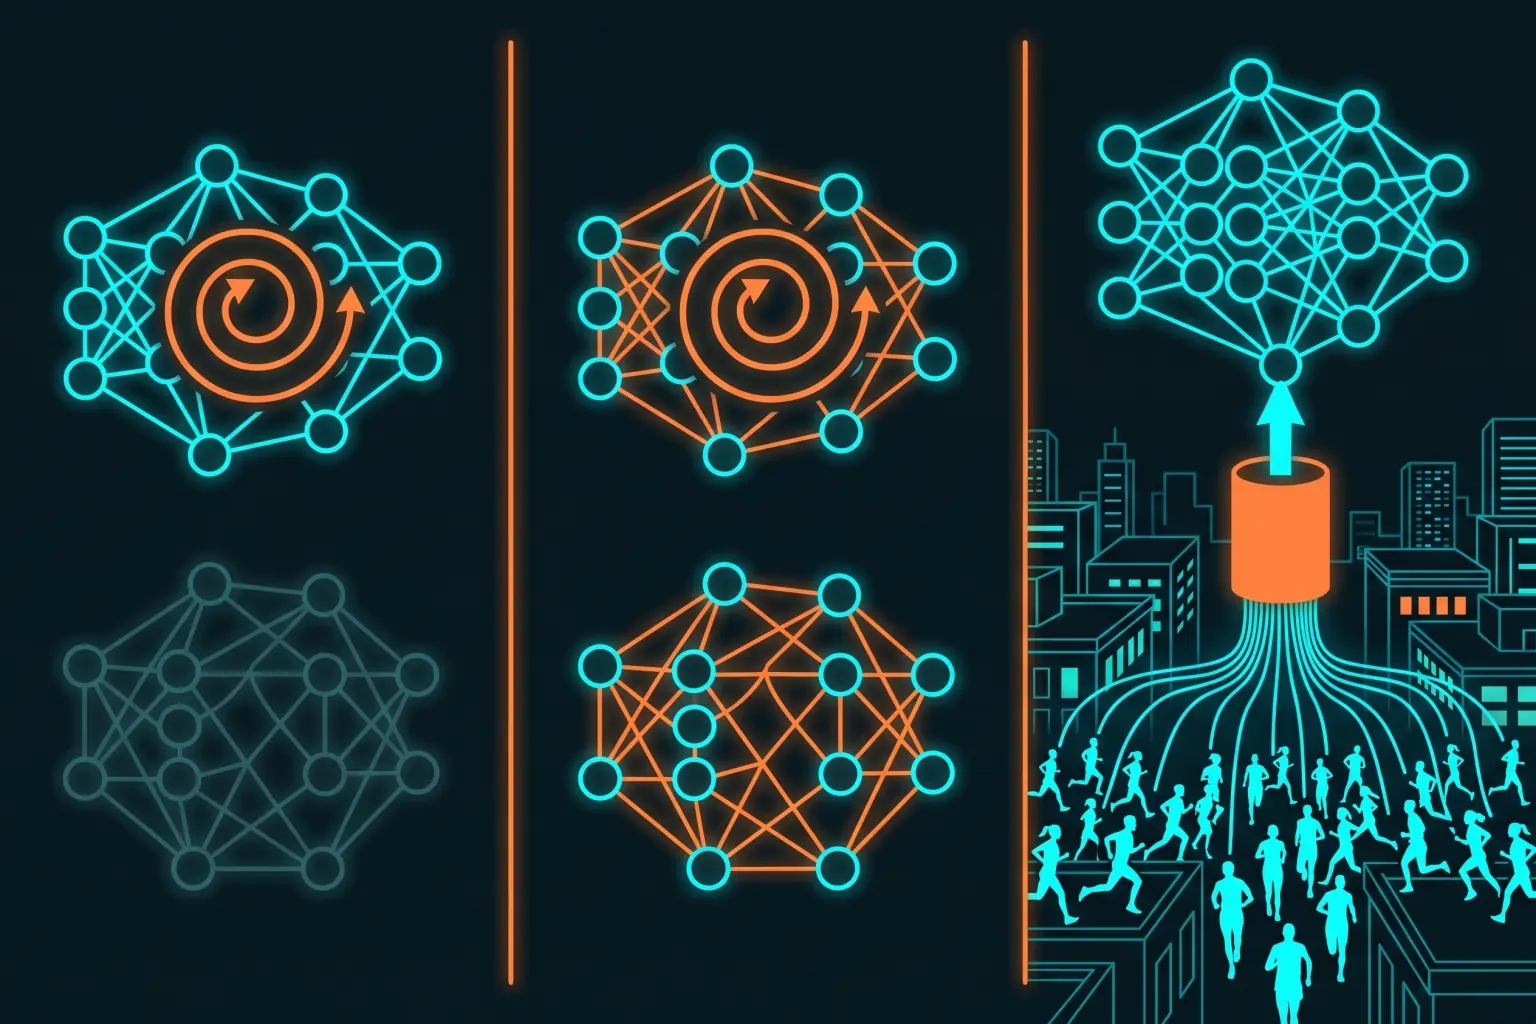
Um genoma aprende a correr, recebe sua pontuação e chega a uma bifurcação: esquecer os novos pesos, herdá-los ou reunir a execução para um único aprendiz compartilhado. Cada escolha muda o que a evolução realmente seleciona. Esquecer premia um ponto de partida que aprende bem; herdar pode deslocar as fronteiras entre espécies; reunir experiências permite que um aprendiz reaproveite o que todos os 150 genomas fizeram.
Os três treinadores estão especificados antes da primeira execução. Cada orçamento abaixo é uma escolha de design, e nada neste post é um resultado medido.
Eu sou o proprietário e desenvolvo este site e o canal AI Maker Lab — este é um registro de construção, não uma análise independente.
Três maneiras de usar um gradiente
O registro de construção anterior levou o ajuste das recompensas para dentro do experimento. Este coloca o aprendizado ao longo da vida dentro da avaliação de fitness. O primeiro registro de IA estabeleceu a comparação baseada somente em evolução para Skyline Run; esta comparação mantém o jogo fixo e muda o que a evolução pode recompensar.
A propriedade que viabiliza isso já existe no código. Todo genoma NEAT deste projeto é acíclico por construção, os nós ocultos usam tanh e os nós de saída são lineares. Seu fenótipo — a rede atuante na qual um genoma se desdobra — é, portanto, um grafo acíclico dirigido diferenciável que pode servir diretamente como uma rede Q sem mudar a representação. Colocar o aprendizado por gradiente dentro da avaliação é uma escolha de design, não uma questão de viabilidade.
A literatura se recusa a escolher uma vencedora
O aprendizado pode guiar a evolução sem herança. “How Learning Can Guide Evolution”, de Hinton e Nowlan, mostra como o aprendizado remodela o espaço de busca e permite que organismos capazes de aprender evoluam mais rápido mesmo quando características adquiridas não são transmitidas ao genótipo. Isso sustenta a variante baldwiniana: aprender durante a vida, pontuar o desempenho aprendido e então descartar os pesos. Se o mesmo efeito aparecerá neste jogo continua sendo uma pergunta em aberto.
As buscas baldwiniana e lamarckiana não são intercambiáveis, e nenhuma vence por padrão. A gravação lamarckiana significa copiar os pesos aprendidos de volta para o genoma. “Lamarckian Evolution, the Baldwin Effect and Function Optimization”, de Whitley, Gordon e Mathias, apresenta funções nas quais um algoritmo genético comum e a evolução lamarckiana convergem para o mesmo ótimo local enquanto a busca baldwiniana chega ao ótimo global, além de casos em que a busca baldwiniana supera a evolução lamarckiana usando a mesma busca local. O resultado não escolhe uma vencedora aqui. Em vez disso, explica por que as três variantes continuam como algoritmos selecionáveis separados.
A literatura sobre o efeito Baldwin também é um alerta. “Myths and Legends of the Baldwin Effect”, de Turney, é a razão pela qual não prometo benefício antecipadamente. Um efeito conhecido pelo nome não é evidência de que algum destes treinadores planejados melhorará o jogo.
Evoluir a topologia enquanto os pesos são treinados por gradiente tem precedente. “Evolving Deep Neural Networks”, de Miikkulainen et al., descreve o CoDeepNEAT, no qual o fitness depende de quão bem uma arquitetura evoluída pode ser treinada por descida do gradiente e cada cromossomo é convertido em uma rede e treinado por um número fixo de épocas. Esse precedente sustenta um orçamento fixo de treinamento interno para cada genoma. Ele não pode determinar qual deve ser esse orçamento aqui.
A ERL é o design com repetição compartilhada. O aprendizado por reforço evolutivo, ou ERL, combina uma população e um aprendiz por gradiente que compartilham experiências. “Evolution-Guided Policy Gradient in Reinforcement Learning”, de Khadka e Tumer, coloca um agente de aprendizado por reforço ao lado de uma população evolutiva, treina ambos em paralelo e compartilha um buffer de repetição. A ERL recicla as experiências da população evolutiva para que um aprendiz extraia mais informação delas e atue como um guia conduzido pela população. Aqui, o aprendizado Q off-policy torna válido o design escolhido de um único buffer alimentado por 150 genomas diferentes. O desempenho desse design em Skyline Run ainda não foi medido.
A CERL amplia a repetição compartilhada para um portfólio de aprendizes. “Collaborative Evolutionary Reinforcement Learning”, de Khadka et al., sucede a ERL com um portfólio de aprendizes em vez de apenas um. Escolhi o design da ERL com um único aprendiz para limitar seu custo no navegador, portanto a CERL documenta uma direção não adotada. Ainda não sabemos qual design funcionará melhor neste jogo.
O NEAT fornece a representação de que esta construção precisa. “Evolving Neural Networks through Augmenting Topologies”, de Stanley e Miikkulainen, estabelece a especiação e o crossover alinhado por números de inovação entre topologias variáveis. Essa mecânica permite que a evolução faça crossover de um genoma treinado por gradiente. Ela comprova que a representação admite o ciclo, não que o aprendizado ajudará em Skyline Run.
Aplicar mutação a uma rede treinada por gradiente é o modo de falha conhecido. “Proximal Distilled Evolutionary Reinforcement Learning”, de Bodnar, Day e Lió, atribui os problemas de escalabilidade da ERL à codificação genética simples e aos operadores de variação tradicionais destrutivos, que causam esquecimento catastrófico das características adquiridas. O crossover do NEAT alinha genes correspondentes pelo número de inovação em vez de combinar vetores desalinhados. Isso pode tornar um genoma injetado menos frágil do que as codificações diretas estudadas pelo PDERL, mas é uma hipótese local, não uma descoberta.
Um jogo, três formas de levar o aprendizado adiante
O seletor do laboratório de IA chama as variantes planejadas de NEAT + DQN (Baldwin), NEAT + retropropagação (Lamarck) e NEAT + DQN compartilhada (ERL). Cada número abaixo é um valor escolhido, salvo indicação em contrário. Nenhum deles é uma medição.
| Variante | O que muda | Como é o sucesso |
|---|---|---|
| Baldwiniana | Os pesos aprendidos dentro da avaliação são descartados. | Superar o NEAT comum nas mesmas seeds, repetir o resultado em seeds ainda não vistas e produzir conclusões. |
| Lamarckiana | Pesos e biases aprendidos são copiados de volta para os genes. | Superar o NEAT comum nas mesmas seeds, repetir o resultado em seeds ainda não vistas e produzir conclusões. |
| ERL | Um aprendiz compartilhado reaproveita a experiência da população e injeta um genoma. | Superar o NEAT comum nas mesmas seeds, repetir o resultado em seeds ainda não vistas e produzir conclusões. |
As três reutilizam o fitness moldado escolhido que o NEAT comum já usa: maior progresso, 250 por checkpoint, 1500 por uma conclusão, 0.5 por tick não utilizado sob o limite de 3600 ticks e 25 por morte. Manter essa definição fixa fará com que as curvas futuras de fitness sejam comparáveis entre si e com o NEAT comum. As três são semeadas e determinísticas por design, então a mesma seed reproduzirá as mesmas estatísticas por geração.
Os gradientes usam uma passagem para trás em ordem topológica inversa pelo próprio grafo do genoma, com um slot de gradiente para cada conexão habilitada e um para cada bias de nó. O Adam aplica as atualizações no próprio grafo.
Baldwiniano: aprender, pontuar, esquecer
A população escolhida é 32, com 4 espécies-alvo. Cada genoma passa por ajuste fino isoladamente durante 2 episódios ε-greedy com ε constante de 0.2, seguidos por 1 episódio de avaliação greedy. O fitness moldado dessa avaliação se torna a pontuação do genoma.
O Double-DQN interno usa γ escolhido de 0.99, taxa de aprendizado 1e-3, batch de 32 e um anel de repetição de 4096 transições, reiniciado para cada genoma. O aprendizado espera um aquecimento de 128 transições, atualiza a rede-alvo a cada 128 atualizações de gradiente e usa a perda Huber — erro quadrático perto de zero e linear para erros grandes — com δ 1.
Os pesos treinados são então descartados. O genoma que se reproduz é o genoma que nasceu, portanto a seleção recompensa um bom ponto de partida para aprender. A consequência honesta é que o campeão exportado joga com seus pesos anteriores ao aprendizado.
Lamarckiano: aprender, pontuar, manter
A população, o alvo de espécies, os episódios, a exploração, a avaliação, os ajustes de Double-DQN, o anel de repetição, o aquecimento, a atualização da rede-alvo e a perda Huber usam os mesmos valores escolhidos do ciclo baldwiniano. Uma linha muda: os pesos e biases treinados são gravados de volta nos genes de conexão e de nós, limitados a ±4.
Esses pesos são herdados, então um progresso mais rápido dos pesos entre gerações é a expectativa a ser testada, não um resultado medido nem uma afirmação de que esta variante é melhor. A distância de compatibilidade do NEAT — uma medida de quanto dois genomas diferem, usada para agrupá-los em espécies — atribui à diferença média de pesos dos genes correspondentes um coeficiente escolhido de 0.4; mover todos os pesos por descida do gradiente também desloca as fronteiras entre espécies. Espera-se que a especiação seja diferente da execução baldwiniana com a mesma seed. O resultado de Whitley alerta que a herança lamarckiana ainda pode perder.
ERL: um buffer, um aprendiz, uma injeção
O design escolhido mantém uma população completa de 150 executando em lockstep exatamente como o NEAT comum e adiciona 1 aprendiz. Cada decisão de cada membro da população e do aprendiz entra em um anel de repetição compartilhado de 20 000 transições, com a mesma recompensa por decisão já usada pelo laboratório DQN.
Depois de cada rodada em lockstep, quando o aquecimento escolhido de 1000 transições existir, o aprendiz executa 1 passo de gradiente com batch de 64. Seu γ escolhido é 0.99, a taxa de aprendizado é 1e-3 e o intervalo de atualização da rede-alvo é de 500 atualizações. ε diminui de 1 para 0.05 ao longo de 50 000 decisões.
O aprendiz treina um clone da topologia do campeão atual, preservando um genoma NEAT válido e os mesmos números de inovação. Em cada limite de geração, seus pesos treinados são gravados em um genoma que substitui um membro da próxima população. Quando surge um novo campeão, o aprendiz se ancora à nova topologia e reinicia o estado do otimizador, enquanto o buffer de repetição e o cronograma de exploração são mantidos.
Uma vitória precisa resistir a seeds ainda não vistas
O protocolo foi fixado antes de qualquer execução para que a comparação não seja adaptada retroativamente:
- Os quatro algoritmos da família NEAT usam a mesma fase, o mesmo nível de habilidade, o mesmo conjunto de seeds e os mesmos coeficientes de recompensa. O instrumento compartilhado reúne os gráficos atuais do NEAT para fitness, progresso, espécies, complexidade e conclusões, mais uma série de perda interna.
- O risco de medição é explícito: NEAT comum e ERL contam um tick como uma rodada de lockstep da população inteira, enquanto os treinadores baldwiniano e lamarckiano executam os genomas um de cada vez e contam ticks do motor. As curvas por geração são diretamente comparáveis. Comparações por tick ou por tempo de relógio não são, e uma futura afirmação de eficiência amostral terá de ser normalizada antes de significar alguma coisa.
- Evidência exigiria que uma variante superasse o NEAT comum com as mesmas seeds, repetisse o resultado em seeds ainda não vistas e produzisse conclusões, não apenas vitórias em progresso. O modelo exportado, a seed e a configuração devem permanecer disponíveis para que a execução possa ser repetida.
A execução comparativa ainda não aconteceu
A execução que ainda falta compara o NEAT comum, a variante baldwiniana, a lamarckiana e a ERL nas mesmas seeds e depois em seeds ainda não vistas, usando conclusões — não apenas progresso — como critério. Ela ainda não foi realizada, e nenhuma variante é declarada melhor. Os três treinadores estão especificados, mas ainda não foram construídos.
Os riscos em aberto são se um pequeno orçamento de ajuste fino por genoma consegue separar o potencial de aprendizado do ruído; se a gravação lamarckiana desestabiliza a especiação a ponto de prejudicá-la; se a injeção da ERL sobrevive às mutações do NEAT ou é esquecida no sentido descrito pelo PDERL; e se algum desses ciclos cabe no custo de uma aba do navegador.
O que ficou decidido é o que cada treinador muda e quais evidências podem distingui-los; nenhum benefício de desempenho foi comprovado. Enquanto essa comparação segue em aberto, o próximo registro troca o aprendizado de pesos pelo aprendizado da própria mutação: Um editor de genes treinado: um modelo consegue mutar o NEAT melhor que o acaso?
Fontes
- Hinton, Geoffrey E.; Nowlan, Steven J. “How Learning Can Guide Evolution.” Complex Systems 1:495–502, 1987. https://www.cs.toronto.edu/~hinton/absps/evolution.htm. Acessado em 2026-08-21.
- Whitley, Darrell; Gordon, V. Scott; Mathias, Keith. “Lamarckian Evolution, the Baldwin Effect and Function Optimization.” Parallel Problem Solving from Nature — PPSN III, Lecture Notes in Computer Science vol. 866, pp. 6–15, Springer, 1994. https://doi.org/10.1007/3-540-58484-6_245. Acessado em 2026-08-21.
- Turney, Peter D. “Myths and Legends of the Baldwin Effect.” arXiv:cs/0212036. https://arxiv.org/abs/cs/0212036. Acessado em 2026-08-21.
- Miikkulainen, Risto; Liang, Jason; Meyerson, Elliot; Rawal, Aditya; Fink, Dan; Francon, Olivier; Raju, Bala; Shahrzad, Hormoz; Navruzyan, Arshak; Duffy, Nigel; Hodjat, Babak. “Evolving Deep Neural Networks.” arXiv:1703.00548, March 4, 2017. https://arxiv.org/abs/1703.00548. Acessado em 2026-08-21.
- Khadka, Shauharda; Tumer, Kagan. “Evolution-Guided Policy Gradient in Reinforcement Learning.” Advances in Neural Information Processing Systems 31 (NeurIPS 2018), pp. 1196–1208. arXiv:1805.07917. https://arxiv.org/abs/1805.07917. Acessado em 2026-08-21.
- Khadka, Shauharda; Majumdar, Somdeb; Nassar, Tarek; Dwiel, Zach; Tumer, Evren; Miret, Santiago; Liu, Yinyin; Tumer, Kagan. “Collaborative Evolutionary Reinforcement Learning.” Proceedings of the 36th International Conference on Machine Learning, PMLR 97, 2019. http://proceedings.mlr.press/v97/khadka19a/khadka19a.pdf. Acessado em 2026-08-21.
- Bodnar, Cristian; Day, Ben; Lió, Pietro. “Proximal Distilled Evolutionary Reinforcement Learning.” Proceedings of the AAAI Conference on Artificial Intelligence 34(04), 2020. arXiv:1906.09807. https://arxiv.org/abs/1906.09807. Acessado em 2026-08-21.
- Stanley, Kenneth O.; Miikkulainen, Risto. “Evolving Neural Networks through Augmenting Topologies.” Evolutionary Computation 10(2):99–127, 2002. https://doi.org/10.1162/106365602320169811. Acessado em 2026-08-21.
Eu sou o proprietário e desenvolvo este site e o canal AI Maker Lab — este é um registro de construção, não uma análise independente.