
Aprendendo a ler o nível: substituindo saltos de sorte por um gradiente de política
O campeão anterior do NEAT concluiu district-01, mas terminou 0 de 30 episódios em níveis gerados que nunca tinha visto. Isso significa trinta tentativas em níveis inéditos para o agente e nenhuma conclusão. O registro da armadilha da memorização contém esse resultado medido; o campeão parecia um jogador em uma rota familiar e uma sequência de saltos de sorte em todas as outras.
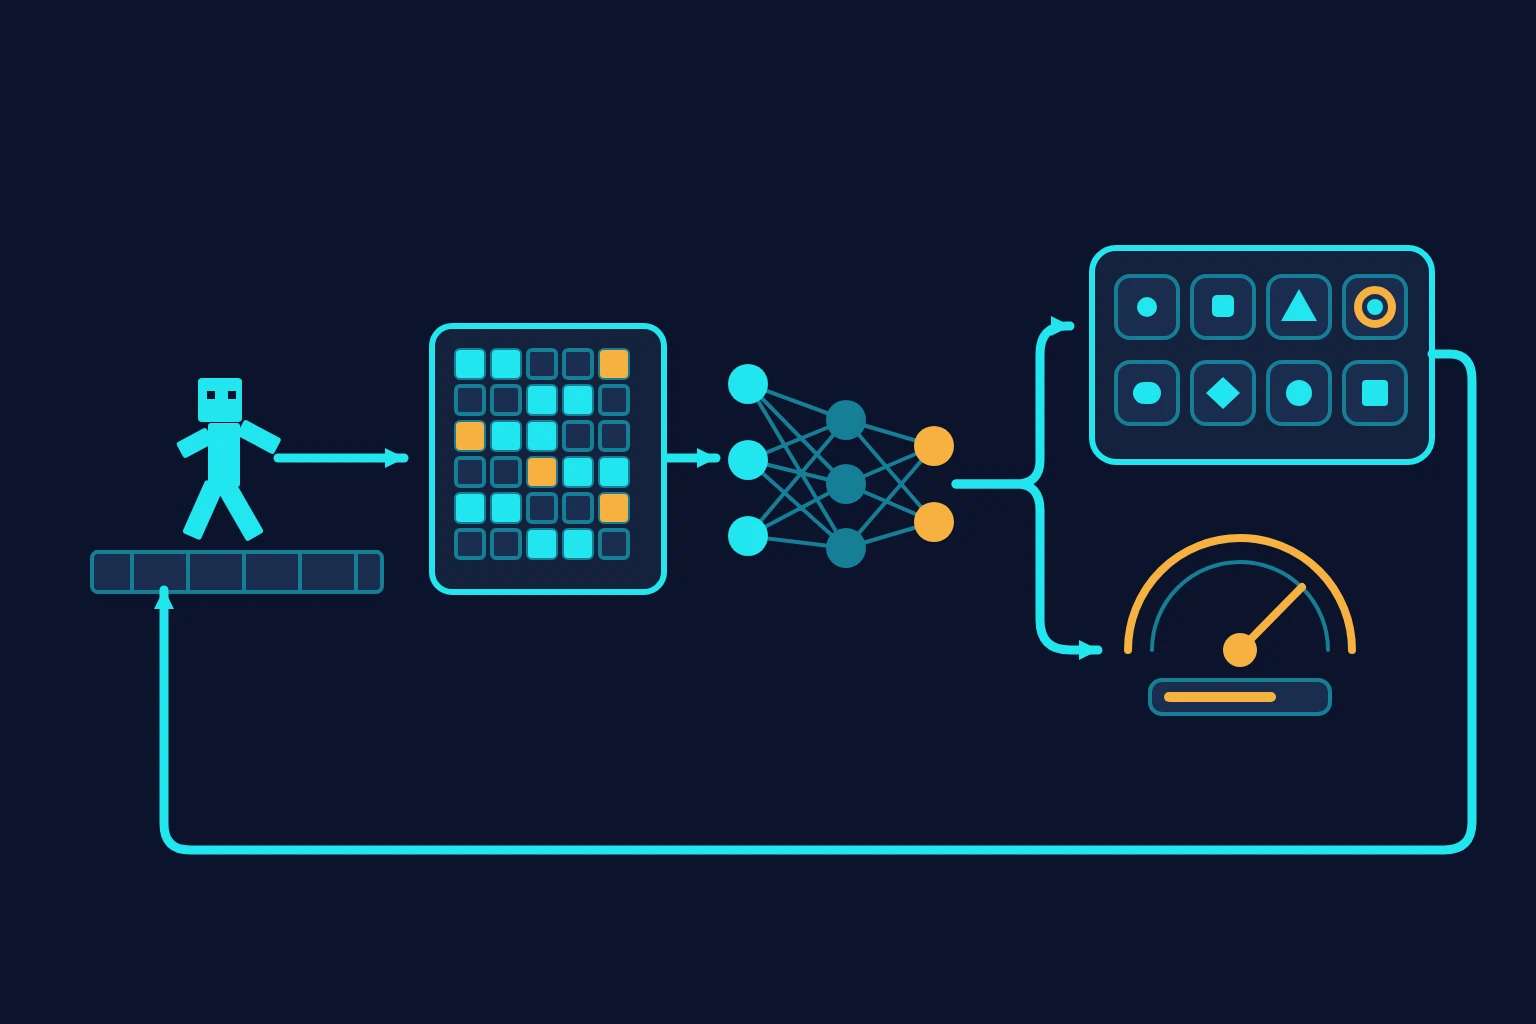
É essa a diferença que esta construção pretende testar. Um controlador em malha aberta (open-loop) repete uma sequência de ações memorizada, enquanto uma política em malha fechada reage ao que a tela mostra agora, mapeando cada nova observação para uma ação. O trabalho de Hausknecht e Stone de 2015 com DQN recorrente explica por que o histórico de observações pode importar quando o quadro atual está incompleto. Ele oferece um mecanismo de controle dependente da observação, não uma prova de que o antigo campeão do Skyline Run ignorava sua observação ou de que a recorrência é necessária aqui.
O próximo experimento substitui a seleção evolutiva de episódios inteiros por gradientes de política a cada decisão, treina sobre uma distribuição de distritos e pode começar com partidas humanas salvas no jogo disponível para jogar. A implementação está no laboratório de IA do Skyline Run; uso o post anterior sobre aprendizado e evolução como comparação para colocar a descida de gradiente dentro do NEAT.
Nenhuma execução de treinamento com PPO nem etapa de clonagem comportamental aconteceu. Todos os números abaixo são valores de projeto escolhidos, não medições, e estou fixando a comparação antes que seu resultado exista.
Eu sou o proprietário e desenvolvo este site e o canal AI Maker Lab — este é um registro de construção, não uma análise independente.
Sete artigos, uma pergunta ainda sem resposta
A Otimização de Política Proximal de Schulman e seus colegas transforma a melhoria da política em atualizações repetidas e limitadas. Seu objetivo substituto com recorte limita o quanto uma atualização pode deslocar a política, mesmo quando o PPO faz várias passagens de otimização pelas decisões amostradas. Isso oferece a esta construção um método prático de gradiente de política on-policy. Não estabelece que o PPO aprenderá o Skyline Run, generalizará para novos distritos ou superará o NEAT aqui.
A Estimativa Generalizada de Vantagem de Schulman e seus colegas fornece o sinal de crédito para cada decisão. GAE, ou estimativa generalizada de vantagem, combina estimativas de curto e longo prazo de quanto uma ação foi melhor. Ela forma um estimador ponderado exponencialmente que troca viés por variância por meio de gamma e lambda, permitindo que resultados posteriores atribuam crédito a ações anteriores. O estimador e sua relação entre viés e variância estão estabelecidos; ainda não sabemos se 0.99 e 0.95 combinam com o ritmo deste jogo.
O benchmark Procgen de Cobbe e seus colegas transforma a distribuição de níveis de treinamento em parte da pergunta algorítmica. Os experimentos mostram uma diferença substancial de generalização entre o treinamento e níveis procedurais inéditos, além de mudanças no desempenho conforme o número de níveis de treinamento. A consequência é direta: a diversidade dos níveis precisa ser medida, não presumida. O resultado não estabelece que o gerador de distritos desta construção, o conjunto de treinamento escolhido ou as cinco seeds do conjunto de validação retido (hold-out) sejam suficientes.
O texto “37 Implementation Details of PPO”, de Huang e seus colegas, mostra que a descrição curta do algoritmo não contém toda a implementação. O trabalho de reprodução identifica ambientes vetorizados — muitas cópias do jogo avançando em paralelo para preencher um lote —, além do tratamento de limites do GAE, minibatches por permutação completa, normalização da vantagem em cada minibatch, regularização por entropia e corte da norma do gradiente entre os detalhes que moldam um resultado fiel do PPO. Esse trabalho me dá uma linhagem de implementação e uma lista de verificação, não a garantia de que este treinador no navegador está correto nem de que estes hiperparâmetros escolhidos são ideais.
O Deep Q-learning from Demonstrations, de Hester e seus colegas, mostra que demonstrações podem dar impulso inicial ao aprendizado por reforço. O DQfD combina dados de demonstração com objetivos de diferença temporal e uma perda supervisionada de grande margem, mantendo as demonstrações no replay enquanto o agente aprende. Essa é uma rota bem-sucedida da demonstração ao aprendizado por reforço para aprendizado de valor. Ela não mostra que uma clonagem comportamental simples antes do PPO preservará a competência nem que uma partida humana basta.
O trabalho Kickstarting, de Schmitt e seus colegas, mostra que um professor pode reduzir a experiência necessária para uma nova política. Nas tarefas estudadas, uma perda auxiliar de destilação permitiu que um aluno igualasse o desempenho do treinamento do zero com cerca de dez vezes menos passos no ambiente enquanto continuava a otimizar a recompensa da tarefa. O resultado de eficiência de amostras pertence àquele cenário entre professor e aluno. Ele não promete um ganho de dez vezes no Skyline Run, onde o professor é um fluxo projetado de entradas humanas, e não outra rede de política.
Go-Explore, de Ecoffet e seus colegas, é a ferramenta para exploração difícil que escolhi não usar. Primeiro, o Go-Explore retorna a estados promissores arquivados; depois, explora a partir deles, separando a recuperação confiável de estados da exploração em jogos esparsos e enganosos. Isso estabelece uma estratégia poderosa para exploração difícil, mas não que o Skyline Run precise de seu mecanismo de arquivar e retornar. Este jogo já oferece uma recompensa densa de progresso e recompensas de checkpoint, então esta construção usa execuções (rollouts) comuns em vários níveis e inícios aleatórios em checkpoints.
A política precisa reagir, não repetir
O ator é um perceptron multicamada escolhido com formato [443, 48, 8]: 443 valores de observação, uma camada oculta de 48 unidades com tanh e 8 logits lineares de ação. O crítico é uma rede separada [443, 48, 1], com a mesma ativação oculta e uma estimativa linear de valor. A largura fixa do ator mantém sua visualização e capacidade comparáveis às políticas existentes de DQN e algoritmo genético; essa conveniência não é evidência de que 48 unidades bastam.
O projeto separa a escolha da ação, o processo de aprendizado e o teste final para que uma curva de treinamento melhor não seja confundida com uma capacidade de jogo transferível.
| Camada | O que ela decide | Como é medida |
|---|---|---|
| Política | Qual das 8 ações discretas tomar a partir da observação atual de 443 valores | Distribuição das ações pelos 8 logits em cada tick de decisão |
| Treinamento | Como as decisões amostradas atualizam o ator e o crítico, opcionalmente após clonagem comportamental | Os lotes do PPO usam a recompensa fixa abaixo; ainda não existe curva de recompensa |
| Avaliação | Se o ator exportado transfere o aprendizado para além dos distritos de treinamento | Conclusões e progresso em todos os distritos da campanha e mais 5 seeds do conjunto retido |
Os hiperparâmetros transformam uma restrição adequada ao navegador no contraste principal: 8 ambientes paralelos preenchem cada lote de 1024 decisões, enquanto a avaliação permanece separada e ocorre a cada 10 iterações.
A execução escolhida usa 8 ambientes e um horizonte de 128 decisões por ambiente, produzindo um lote de 1024 decisões. O desconto escolhido é gamma = 0.99; o GAE usa lambda = 0.95; o epsilon de recorte do PPO é 0.2. Cada lote recebe 4 épocas de atualização com minibatches de 256, taxa de aprendizado 2.5e-4, coeficiente de entropia 0.01, coeficiente da perda de valor 0.5 e norma global máxima do gradiente 0.5. Cada avanço do navegador processa no máximo 64 amostras de atualização, e a avaliação no conjunto retido está agendada a cada 10 iterações.
O ambiente 0 permanece fixado ao distrito exibido na tela para que seu corredor continue fazendo sentido para quem observa. Os outros sete ambientes escolhem entre os distritos de treinamento com um cursor round-robin determinístico na construção e depois de cada episódio. A distribuição, não uma rota principal de sorte, pretende criar pressão para uma política que leia a observação de 443 valores.
A recompensa por decisão é deliberadamente idêntica à do laboratório de DQN: -0.01 por decisão, + progress_px / TILE por novo progresso horizontal, +2 por checkpoint, +20 na conclusão e -2 por morte. Manter essa definição fixa torna comparáveis as curvas de recompensa futuras; nenhuma existe ainda.
Uma demonstração humana salva contém um nibble de quatro bits para cada tick do motor a 60 Hz: o bit 0 indica esquerda; o bit 1, direita; o bit 2, salto; e o bit 3, dash. O motor de passo fixo do Skyline Run é determinístico, portanto o mesmo fluxo de nibbles repete a mesma partida no mesmo nível e na mesma versão do motor. O gravador salva apenas partidas concluídas, e o carregador as repete para confirmar que ainda chegam ao fim.
Antes do aprendizado por reforço, a fase opcional de clonagem comportamental repete cada demonstração válida, copia uma observação em cada tick de decisão e a rotula com uma das 8 ações discretas do ator. A entrada humana livre com quatro botões nem sempre equivale a uma dessas 8 ações, então a projeção escolhe a ação com a distância de Hamming mínima — o menor número de bits de botão diferentes — e resolve empates pelo índice da ação. O ator então recebe 10 épocas escolhidas de clonagem comportamental, tamanho de lote 64, taxa de aprendizado 1e-3 e limite de 50.000 amostras. A entropia cruzada treina os rótulos de ação projetados; ela não ensina o crítico nem garante que o ritmo humano sobreviva à projeção.
Um arquivo de modelo PPO exporta apenas o ator. Carregar esse arquivo restaura os pesos da política e depois retoma o aprendizado por reforço com um crítico e um estado do otimizador recém-inicializados. Portanto, a exportação é um retrato jogável da política, não um checkpoint completo de treinamento.
Concluir níveis inéditos é o critério
O avaliador existente fornece o protocolo: cada modelo joga todos os distritos da campanha e mais 5 seeds geradas do conjunto retido, com 3 episódios por nível. A passagem completa roda primeiro com probabilidade de ações persistentes (sticky actions) igual a 0 e depois novamente com 0.25, quando um quarto das decisões repete a ação anterior. O modelo, a seed, a configuração e as seeds dos níveis gerados continuam fazendo parte das evidências para que a comparação possa ser repetida.
O resultado que conta é concluir níveis gerados inéditos. A fração de progresso continua sendo um diagnóstico útil de onde uma política para, mas progresso sem conclusões não estabelece uma capacidade de jogo transferível. Uma política PPO que avance mais, mas ainda não conclua nenhum nível inédito, não superou o padrão definido pelo diagnóstico de memorização.
A execução decisiva de treinamento ainda não aconteceu
Nenhuma iteração de PPO, época de clonagem comportamental ou avaliação no conjunto retido foi executada. Este post não alega curva de aprendizado, conclusão, aceleração nem vantagem sobre outro algoritmo.
Talvez o ator de 48 unidades ocultas não tenha capacidade para transformar uma observação de tiles com 443 valores em ações robustas. Talvez o orçamento de ticks do navegador não comporte amostras suficientes para um método on-policy, mesmo com oito ambientes em sincronia. A clonagem comportamental também pode introduzir ruído nos rótulos: uma pessoa pode pressionar qualquer uma das 16 combinações de botões, enquanto a política oferece apenas 8 ações; assim, a projeção pela distância mínima de Hamming pode apagar a intenção justamente quando duas combinações empatam.
Esses são resultados do experimento, não desculpas de implementação. Uma curva de retorno plana, uma política que se ajuste demais aos distritos de treinamento ou um pré-treinamento que piore o PPO precisam continuar sendo resultados publicáveis sob este protocolo. O próximo passo é executar o protocolo fixo de treinamento e avaliação; o próximo post terá de responder a uma pergunta exata: a política treinada consegue concluir níveis inéditos?
Fontes
- Hausknecht, Matthew; Stone, Peter. “Deep Recurrent Q-Learning for Partially Observable MDPs.” AAAI Fall Symposium Series, 2015. arXiv:1507.06527. https://arxiv.org/abs/1507.06527. Acessado em 2026-08-21.
- Schulman, John; Wolski, Filip; Dhariwal, Prafulla; Radford, Alec; Klimov, Oleg. “Proximal Policy Optimization Algorithms.” arXiv:1707.06347, 2017. https://arxiv.org/abs/1707.06347. Acessado em 2026-08-21.
- Schulman, John; Moritz, Philipp; Levine, Sergey; Jordan, Michael; Abbeel, Pieter. “High-Dimensional Continuous Control Using Generalized Advantage Estimation.” arXiv:1506.02438, 2015. https://arxiv.org/abs/1506.02438. Acessado em 2026-08-21.
- Cobbe, Karl; Hesse, Christopher; Hilton, Jacob; Schulman, John. “Leveraging Procedural Generation to Benchmark Reinforcement Learning.” Proceedings of the 37th International Conference on Machine Learning, PMLR 119:2048–2056, 2020. arXiv:1912.01588. https://arxiv.org/abs/1912.01588. Acessado em 2026-08-21.
- Huang, Shengyi; Dossa, Rousslan Fernand Julien; Ye, Chang; Braga, João; Chakraborty, Dipam; Mehta, Kinal; Araújo, João G. M. “The 37 Implementation Details of Proximal Policy Optimization.” ICLR Blog Track, 2022. https://iclr-blog-track.github.io/2022/03/25/ppo-implementation-details/. Acessado em 2026-08-21.
- Hester, Todd; Vecerik, Matej; Pietquin, Olivier; Lanctot, Marc; Schaul, Tom; Piot, Bilal; Horgan, Dan; Quan, John; Sendonaris, Andrew; Osband, Ian; Dulac-Arnold, Gabriel; Agapiou, John; Leibo, Joel Z.; Gruslys, Audrunas. “Deep Q-learning from Demonstrations.” Proceedings of the AAAI Conference on Artificial Intelligence 32(1), 2018. arXiv:1704.03732. https://arxiv.org/abs/1704.03732. Acessado em 2026-08-21.
- Schmitt, Simon; Hudson, Jonathan J.; Zidek, Augustin; Osindero, Simon; Doersch, Carl; Czarnecki, Wojciech M.; Leibo, Joel Z.; Kuttler, Heinrich; Zisserman, Andrew; Simonyan, Karen; Eslami, S. M. Ali. “Kickstarting Deep Reinforcement Learning.” arXiv:1803.03835, 2018. https://arxiv.org/abs/1803.03835. Acessado em 2026-08-21.
- Ecoffet, Adrien; Huizinga, Joost; Lehman, Joel; Stanley, Kenneth O.; Clune, Jeff. “First Return, Then Explore.” Nature 590:580–586, 2021. https://doi.org/10.1038/s41586-020-03157-9. Acessado em 2026-08-21.
Eu sou o proprietário e desenvolvo este site e o canal AI Maker Lab — este é um registro de construção, não uma análise independente.