
ゲノムはネットワークが学んだことを残すべきか? 勾配と進化を組み合わせる三つの方法
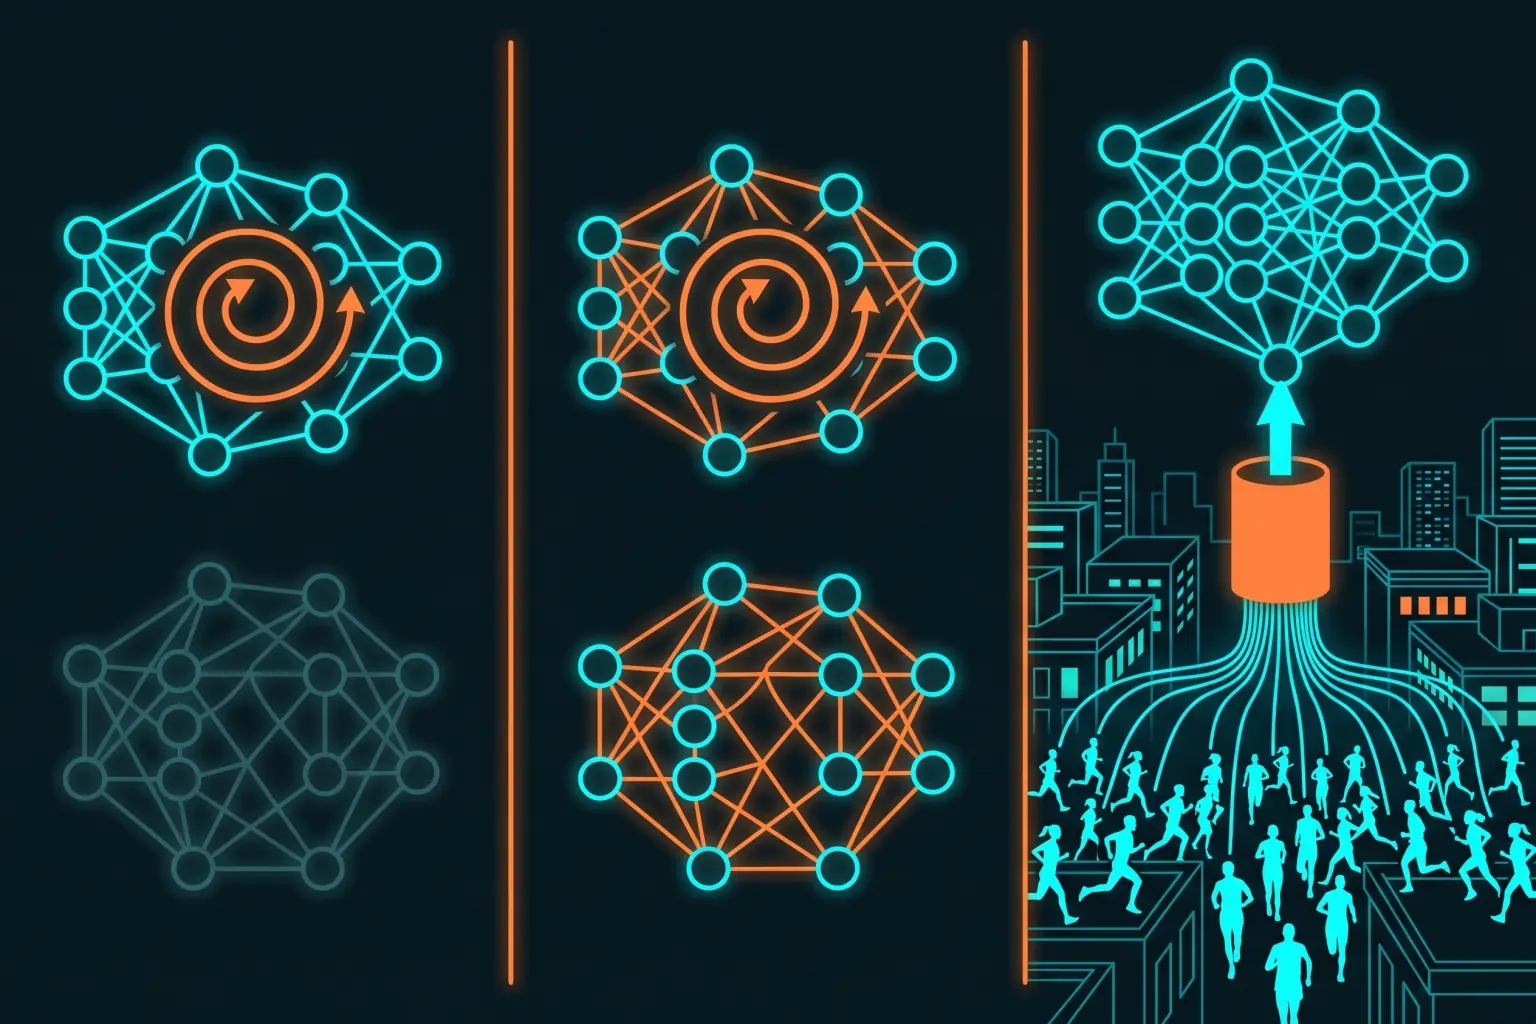
ゲノムが走り方を学び、得点を得た直後、三つの道が分かれます。新しい重みを忘れるのか、継承するのか、それとも一回の走行を共有学習器へ集めるのか。忘れれば学びやすい出発点が選ばれ、継承すれば種の境界が動き、共有すれば一つの学習器が150個すべてのゲノムの経験を再利用できます。
三つのトレーナーは、最初の実行より前に仕様を定めます。以下の予算はすべて設計上選んだ値であり、この記事に測定結果はありません。
このサイトとAI Maker Labチャンネルは私が所有し、制作しています。これは制作記録であり、第三者による独立したレビューではありません。
一つの勾配を使う三つの道
前回の制作記録では、報酬調整を実験の内側へ移しました。今回は、生涯学習を適応度評価の内側へ置きます。最初のAI制作記録は、Skyline Runで進化だけを使う比較基準を定めました。この比較ではゲームを固定し、進化が報いる対象だけを変えます。これを可能にする性質は、すでにコードにあります。このプロジェクトのすべてのNEATゲノムは構造上非巡回で、隠れノードはtanh、出力ノードは線形です。そのため表現型、つまりゲノムから展開されて実際に動くネットワークは、微分可能な有向非巡回グラフになります。表現を変えず、そのままQネットワークとして使えます。評価の内側に勾配学習を置くことは、実現可能性の問題ではなく設計上の選択です。
文献も勝者は選べない
学習は、獲得形質を継承しなくても進化を導けます。 HintonとNowlanの“How Learning Can Guide Evolution”は、獲得形質が遺伝子型へ伝達されなくても、学習が探索空間を作り変え、学習できる生物の進化を速めることを示します。これがボールドウィン型、つまり生涯の中で学習し、学習後の性能を採点してから重みを捨てる方式の根拠です。このゲームでも同じ効果が現れるかは、まだ答えのない問いです。
ボールドウィン型探索とラマルク型探索は同じではなく、どちらかが常に勝つわけでもありません。 ラマルク型の書き戻しとは、学習後の重みをゲノムへコピーすることです。Whitley、Gordon、Mathiasの“Lamarckian Evolution, the Baldwin Effect and Function Optimization”は、通常の遺伝的アルゴリズムとラマルク型進化が同じ局所最適解へ収束する一方、ボールドウィン型探索が大域最適解へ到達する関数と、同じ局所探索を使ってボールドウィン型探索がラマルク型進化を上回る場合を示します。この結果から今回の勝者は選べません。だから三方式を別々に選択できるアルゴリズムとして残します。
ボールドウィン効果の文献は、同時に注意も促します。 Turneyの“Myths and Legends of the Baldwin Effect”があるからこそ、私は利点を事前に主張しません。名前の付いた効果があることは、計画中のトレーナーがゲームを改善する証拠ではありません。
トポロジーを進化させながら、勾配降下法で重みを訓練することには先例があります。 Miikkulainen et al.の“Evolving Deep Neural Networks”はCoDeepNEATを説明しています。そこでは、進化したアーキテクチャを勾配降下法でどれだけ訓練できるかによって適応度を定め、各染色体をネットワークへ変換して固定エポック数だけ訓練します。この先例は、各ゲノムに固定の内側訓練予算を割り当てる根拠になります。ただし、今回の予算値は教えてくれません。
ERLは共有リプレイの設計です。 ERLとは進化的強化学習のことで、経験を共有する個体群と勾配学習器を組み合わせます。KhadkaとTumerの“Evolution-Guided Policy Gradient in Reinforcement Learning”は、一つの強化学習エージェントを進化的個体群と並べ、並列に訓練し、リプレイバッファを共有します。ERLは進化的個体群が生成した経験を再利用し、一つの学習器がそこからより多くの情報を取り出して、個体群に導かれる案内役となります。ここでは方策外Q学習によって、異なる150ゲノムが一つのバッファへ経験を送る設計が成立します。Skyline Runでの性能はまだ測定していません。
CERLは共有リプレイを、複数の学習器からなる集まりへ広げます。 Khadka et al.の“Collaborative Evolutionary Reinforcement Learning”は、一つではなく複数の学習器を使うERLの後継方式です。今回はブラウザ上のコストを抑えるため、学習器が一つのERL設計を選びます。したがってCERLは、採用しなかった方向の先例です。このゲームでどちらが優れるかは分かっていません。
NEATは、今回の仕組みに必要な表現を提供します。 StanleyとMiikkulainenの“Evolving Neural Networks through Augmenting Topologies”は、種分化と、可変トポロジーをイノベーション番号で揃える交叉を確立しました。この仕組みによって、勾配で訓練したゲノムも進化の交叉対象であり続けます。分かるのは表現がこの処理に対応できることであり、学習がSkyline Runで役立つことではありません。
勾配で訓練したネットワークへの突然変異は、既知の失敗要因です。 Bodnar、Day、Lióの“Proximal Distilled Evolutionary Reinforcement Learning”は、ERLの拡張性の問題を、単純な遺伝的符号化と、獲得した形質の破壊的忘却を引き起こす従来型の変異演算子に結び付けています。NEATの交叉は、整列していないベクトルを混ぜるのではなく、イノベーション番号で対応遺伝子を揃えます。そのため、注入されたゲノムはPDERLが調べた直接符号化より壊れにくいかもしれません。これは今回の仮説であり、発見ではありません。
同じゲームで、学習を先へ運ぶ三つの方法
AIラボの選択欄では、計画中の方式を`NEAT + DQN(ボールドウィン)`、`NEAT + 誤差逆伝播(ラマルク)`、`NEAT + 共有DQN(ERL)`と呼びます。特に記載がない限り、以下の数値はすべて選んだ値です。測定値は一つもありません。| 方式 | 変わるもの | 成功とみなす条件 |
|---|---|---|
| ボールドウィン型 | 評価中に学習した重みを捨てます。 | 同じシードで通常のNEATを上回り、未見のシードでも再現し、クリアを生み出します。 |
| ラマルク型 | 学習した重みとバイアスを遺伝子へ書き戻します。 | 同じシードで通常のNEATを上回り、未見のシードでも再現し、クリアを生み出します。 |
| ERL | 共有学習器が個体群の経験を再利用し、一つのゲノムを注入します。 | 同じシードで通常のNEATを上回り、未見のシードでも再現し、クリアを生み出します。 |
三方式はすべて、通常のNEATが使う既存のシェーピング済み適応度を再利用します。最遠進行度、チェックポイントごとに250、クリアで1500、3600ティック上限の下で未使用の各ティックに0.5、死亡ごとに25です。この定義を固定することで、将来の適応度曲線を三方式の間でも通常のNEATとも比較できます。三方式はすべてシード付きかつ決定論的になるよう設計し、同じシードから同じ世代統計を再現します。
勾配は、ゲノム自身のグラフを逆トポロジー順にたどる逆伝播で計算します。有効な接続ごとに一つ、ノードのバイアスごとに一つの勾配スロットを持ち、Adamがその場で更新します。
ボールドウィン型:学習し、採点し、捨てる
選んだ個体数は32、目標種数は4です。各ゲノムを個別に、一定のε 0.2によるε貪欲法で2エピソード微調整し、その後に貪欲法で1エピソード評価します。その評価のシェーピング済み適応度をゲノムの得点にします。
内側のDouble-DQNには、選んだγ 0.99、学習率1e-3、バッチサイズ32、ゲノムごとに初期化する4096遷移のリプレイリングを使います。128遷移のウォームアップ後に学習を始め、128回の勾配更新ごとにターゲットネットワークを更新します。損失はHuber損失、つまり誤差がゼロに近い範囲では二乗誤差、大きい範囲では線形になる損失で、δは1です。
訓練した重みは捨てます。繁殖するのは生まれた時点のゲノムなので、選択が評価するのは学習の良い出発点です。正直な帰結として、書き出したチャンピオンは学習前の重みでプレイします。
ラマルク型:学習し、採点し、残す
個体数、目標種数、エピソード、探索、評価、Double-DQN設定、リプレイリング、ウォームアップ、ターゲットネットワーク更新、Huber損失は、ボールドウィン型と同じ選択値を使います。一行だけ変わり、訓練した重みとバイアスを接続遺伝子とノード遺伝子へ書き戻し、±4の範囲に収めます。
重みは継承されるため、世代間の重みの進歩がより速くなることが検証対象の予想です。測定結果でも、この方式が優れているという主張でもありません。NEATの互換距離、つまり二つのゲノムがどれだけ異なるかを表し、種へのグループ分けに使う尺度では、対応遺伝子の平均重み差に選んだ係数0.4を掛けます。したがって、勾配降下法ですべての重みを動かすと、種の境界も動きます。同じシードのボールドウィン型実行とは種分化の振る舞いが異なると予想します。Whitleyの結果は、ラマルク型継承でも負ける場合があるという警告です。
ERL:一つのバッファ、一つの学習器、一つの注入
選んだ設計では、通常のNEATと同じく150個体すべてを一斉同期で動かし、さらに1学習器を加えます。各個体と学習器によるすべての判断を、20 000遷移の共有リプレイリングへ、DQNラボがすでに使っている判断ごとの報酬とともに書き込みます。
各一斉同期ラウンドの後、選んだウォームアップの1000遷移が揃ったら、学習器はバッチサイズ64で1回の勾配更新を行います。選んだγは0.99、学習率は1e-3、ターゲットネットワーク更新間隔は500更新です。εは50 000判断をかけて1から0.05へ下げます。
学習器は現在のチャンピオンのトポロジーを複製して訓練するため、有効なNEATゲノムと同じイノベーション番号を保ちます。各世代の境界で、訓練した重みを一つのゲノムへ書き込み、次の個体群の一個体と置き換えます。新しいチャンピオンが現れたら、そのトポロジーへ学習器をつなぎ直し、最適化器の状態を初期化します。リプレイバッファと探索スケジュールはそのまま残します。
勝利には未見のシードでの再現が要る
実行後に都合よく比較方法を変えないよう、実行前に手順を固定します。
- NEAT系の四方式すべてで、同じレベル、スキルレベル、シード集合、報酬係数を使います。既存のNEATグラフである適応度、進行度、種、複雑度、クリア数に、内側の損失系列を加え、共通の計測手段とします。
- 計測上の危険を明記します。通常のNEATとERLは、一個体群全体の一斉同期ラウンドを一ティックとして数えます。一方、ボールドウィン型とラマルク型はゲノムを一つずつ実行し、エンジンティックを数えます。世代ごとの曲線は直接比較できますが、ティックごとや実時間の比較はできません。将来サンプル効率を主張するなら、その前に正規化が必要です。
- 証拠と呼ぶには、同じシードで通常のNEATを上回り、未見のシードでも繰り返し、進行度だけの勝利ではなくクリアを生み出す必要があります。実行を再現できるよう、書き出したモデル、シード、設定を残します。
比較実験はまだ始まっていない
これから行う比較実験では、通常のNEAT、ボールドウィン型、ラマルク型、ERLを同じシードで比べ、次に未見のシードで比べます。基準は進行度だけではなくクリアです。この実験はまだ実行しておらず、どの方式が優れているとも主張しません。三つのトレーナーは仕様を定めただけで、まだ実装していません。
未解決のリスクは、ゲノムごとの小さな微調整予算で学習可能性とノイズを分けられるか、ラマルク型の書き戻しが種分化を害するほど不安定にするか、ERLの注入がNEATの突然変異を生き残るか、またはPDERLが説明する意味で忘れられるか、そしてどの方式もブラウザタブ内で実行可能なコストに収まるかです。
決まったのは、各トレーナーが何を変え、どんな証拠なら方式を区別できるかです。性能上の利点はまだ一つも証明していません。その比較を残したまま、次の制作記録では重みの学習から突然変異そのものの学習へ進みます。学習するゲノム編集者:モデルはランダムより上手くNEATを変異させられるかです。
出典
- Hinton, Geoffrey E.; Nowlan, Steven J. “How Learning Can Guide Evolution.” Complex Systems 1:495–502, 1987. https://www.cs.toronto.edu/~hinton/absps/evolution.htm. 2026-08-21閲覧。
- Whitley, Darrell; Gordon, V. Scott; Mathias, Keith. “Lamarckian Evolution, the Baldwin Effect and Function Optimization.” Parallel Problem Solving from Nature — PPSN III, Lecture Notes in Computer Science vol. 866, pp. 6–15, Springer, 1994. https://doi.org/10.1007/3-540-58484-6_245. 2026-08-21閲覧。
- Turney, Peter D. “Myths and Legends of the Baldwin Effect.” arXiv:cs/0212036. https://arxiv.org/abs/cs/0212036. 2026-08-21閲覧。
- Miikkulainen, Risto; Liang, Jason; Meyerson, Elliot; Rawal, Aditya; Fink, Dan; Francon, Olivier; Raju, Bala; Shahrzad, Hormoz; Navruzyan, Arshak; Duffy, Nigel; Hodjat, Babak. “Evolving Deep Neural Networks.” arXiv:1703.00548, March 4, 2017. https://arxiv.org/abs/1703.00548. 2026-08-21閲覧。
- Khadka, Shauharda; Tumer, Kagan. “Evolution-Guided Policy Gradient in Reinforcement Learning.” Advances in Neural Information Processing Systems 31 (NeurIPS 2018), pp. 1196–1208. arXiv:1805.07917. https://arxiv.org/abs/1805.07917. 2026-08-21閲覧。
- Khadka, Shauharda; Majumdar, Somdeb; Nassar, Tarek; Dwiel, Zach; Tumer, Evren; Miret, Santiago; Liu, Yinyin; Tumer, Kagan. “Collaborative Evolutionary Reinforcement Learning.” Proceedings of the 36th International Conference on Machine Learning, PMLR 97, 2019. http://proceedings.mlr.press/v97/khadka19a/khadka19a.pdf. 2026-08-21閲覧。
- Bodnar, Cristian; Day, Ben; Lió, Pietro. “Proximal Distilled Evolutionary Reinforcement Learning.” Proceedings of the AAAI Conference on Artificial Intelligence 34(04), 2020. arXiv:1906.09807. https://arxiv.org/abs/1906.09807. 2026-08-21閲覧。
- Stanley, Kenneth O.; Miikkulainen, Risto. “Evolving Neural Networks through Augmenting Topologies.” Evolutionary Computation 10(2):99–127, 2002. https://doi.org/10.1162/106365602320169811. 2026-08-21閲覧。
このサイトとAI Maker Labチャンネルは私が所有し、制作しています。これは制作記録であり、第三者による独立したレビューではありません。