
レベルを読む学習:幸運なジャンプを方策勾配に置き換える
以前のNEATチャンピオンはdistrict-01をクリアしましたが、未見の生成レベルでの完走は30エピソード中0回でした。つまり、エージェントが一度も見たことのないレベルに30回挑み、一度もゴールできなかったということです。記憶の罠を記録した記事にその測定結果があります。チャンピオンは、慣れた一つの経路ではプレイヤーらしく見えましたが、それ以外では幸運なジャンプの列にしか見えませんでした。
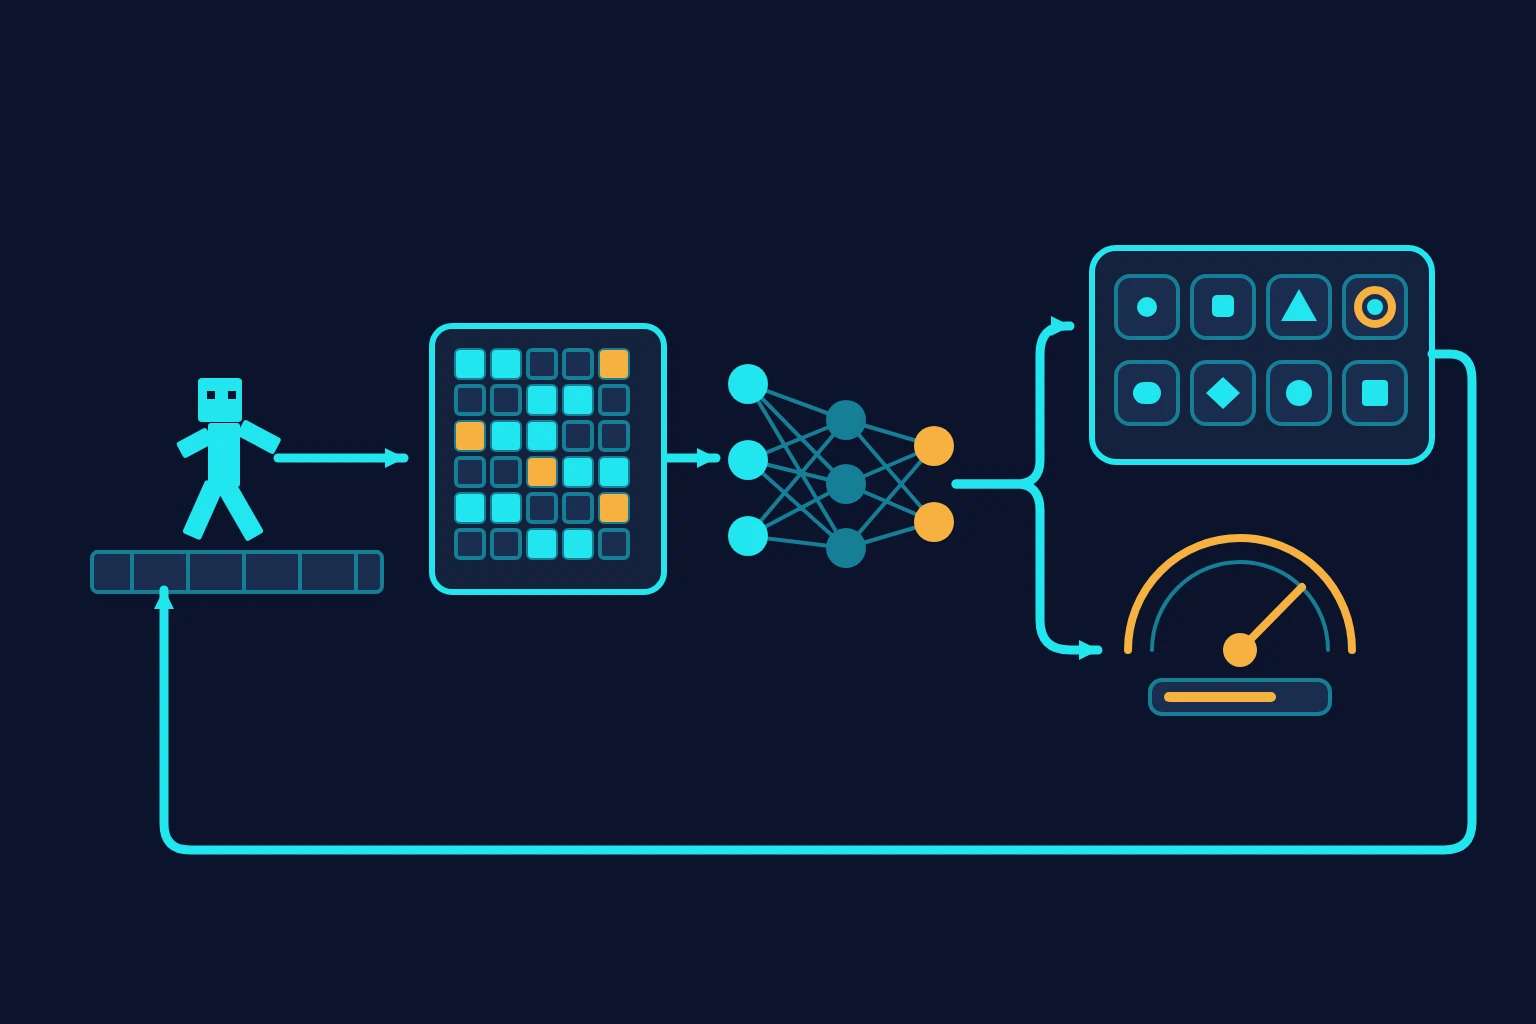
今回の制作で試すのは、この違いです。開ループ制御は記憶した一連の操作を再生します。一方、閉ループ方策は、画面が現在示している内容に反応し、新しい観測ごとに行動を選び直します。HausknechtとStoneによる2015年の再帰型DQN研究は、現在のフレームだけでは情報が足りないときに、観測履歴が重要になり得る理由を説明しています。これは観測に依存する制御の仕組みを示すものであり、以前のSkyline Runチャンピオンが観測を無視していた証明でも、ここで再帰構造が必須だという証明でもありません。
次の実験では、エピソード全体を単位とする進化的選択を、判断ごとの方策勾配に置き換えます。複数の地区から成る分布で訓練し、実際に遊べるゲームに保存した人間のプレイから始めることもできます。実装はSkyline RunのAI実験室にあります。私は、学習と進化についての前の記事を、勾配降下をNEATの内側へ入れる比較に使います。
PPOの訓練も行動クローニングも、まだ一度も実行していません。以下の数字はすべて設計時に選んだ値であり、測定値ではありません。結果が出る前に、私が比較条件を固定します。
このサイトとAI Maker Labチャンネルは私が所有し、制作しています。これは制作記録であり、第三者による独立したレビューではありません。
七つの論文、一つの未回答の問い
Schulmanらの近接方策最適化は、方策の改善を反復可能な制限付き更新に変えます。 PPOのクリップ付き代理目的関数は、一度の更新で方策が動ける幅を制限しながら、収集済みの判断を複数回最適化できます。これで実用的なオン方策型の方策勾配法が得られます。ただし、PPOがSkyline Runを学習すること、新しい地区へ汎化すること、ここでNEATを上回ることは証明されません。
Schulmanらの一般化アドバンテージ推定は、判断ごとの信用割当信号を与えます。 GAE、つまり一般化アドバンテージ推定は、ある行動がどれだけ良かったかについて、短期と長期の推定を混ぜる方法です。gammaとlambdaを通してバイアスと分散を調整する指数加重推定を作り、後の結果から前の行動へ信用を割り当てます。この推定器とバイアス・分散の関係は確立されていますが、0.99と0.95がこのゲームの時間感覚に合うかは未確認です。
CobbeらのProcgenベンチマークは、訓練レベルの分布そのものをアルゴリズム上の問いにしました。 実験では、訓練レベルと未見のプロシージャル生成レベルの間に大きな汎化ギャップがあり、訓練レベル数によって性能も変わりました。結論は明確です。レベルの多様性は仮定せず、測らなければなりません。ただし、この制作の地区生成器、選んだ訓練集合、5個のホールドアウトシードで十分だとは確立されていません。
Huangらの「37 Implementation Details of PPO」は、短いアルゴリズム説明だけでは実装が完成しないことを示します。 再現研究は、ベクトル化環境、つまり多数のゲームを並列に進めてバッチを満たす仕組みに加え、GAEの境界処理、全順列ミニバッチ、ミニバッチごとのアドバンテージ正規化、エントロピー正則化、勾配ノルムのクリップを、忠実なPPO結果を左右する詳細として挙げています。この研究から得られるのは実装の系譜と確認項目であり、ブラウザ訓練器の正しさや、選んだハイパーパラメータの最適性を保証するものではありません。
Hesterらのデモンストレーションを使う深層Q学習は、実演から強化学習を立ち上げられることを示します。 DQfDは、デモデータを時間差分目的と教師あり大マージン損失に組み合わせ、エージェントが学ぶ間もデモを経験再生に残します。これは、価値学習で実演から強化学習へつなぐことに成功した一つの経路です。PPO前の単純な行動クローニングが能力を保つことや、人間の完走1回で十分なことまでは示しません。
Schmittらの学習開始支援の研究は、教師が新しい方策に必要な経験を減らせることを示します。 彼らの課題では、補助的な蒸留損失によって、生徒がタスク報酬を最適化し続けながら、ゼロからの学習と同等の性能へ約10分の1の環境ステップで到達しました。このサンプル効率は、その教師と生徒の設定で得られた結果です。教師が別の方策ネットワークではなく、人間の入力を投影した流れであるSkyline Runに、10倍の改善を約束するものではありません。
EcoffetらのGo-Exploreは、難しい探索のためにあえて採用しなかった手法です。 Go-Exploreは、まず保存済みの有望な状態へ戻り、そこから探索します。こうして、報酬が疎で紛らわしいゲームにおける確実な状態復元と探索を分けます。難しい探索に有力な戦略であることは確立されていますが、Skyline Runに保存と帰還の仕組みが必要だとは示しません。このゲームには密な進行報酬とチェックポイント報酬があるため、今回は通常の複数レベルのロールアウトと、ランダムなチェックポイント開始を使います。
方策は再生せず反応する
アクターには[443, 48, 8]という形の多層パーセプトロンを選びました。443個の観測値、tanhを使う48ユニットの隠れ層、8個の線形な行動ロジットで構成します。クリティックは別の[443, 48, 1]ネットワークで、同じ隠れ層の活性化と一つの線形価値推定を使います。アクターの幅を固定すると、既存のDQN方策や遺伝的アルゴリズム方策と可視化や容量を比較しやすくなりますが、その都合は48ユニットで十分だという根拠ではありません。
設計では、行動の選択、学習過程、最終テストを分離します。訓練曲線が良くなっただけで、別のレベルにも移せるプレイ能力が得られたと誤解しないためです。
| 層 | 決めること | 測り方 |
|---|---|---|
| 方策 | 現在の443個の観測値から8個の離散行動のどれを選ぶか | 判断ティックごとの8個のロジットにわたる行動分布 |
| 訓練 | サンプルした判断からアクターとクリティックをどう更新するか。行動クローニングを先に行う場合もある | PPOバッチは以下の固定報酬を使う。報酬曲線はまだ存在しない |
| 評価 | 書き出したアクターが訓練地区の外へ学習を移せるか | 全キャンペーン地区と5個の生成ホールドアウトシードにおけるクリア数と進行度 |
ハイパーパラメータが示す重要な対比は、ブラウザに収まる8個の並列環境で1024判断のバッチを満たしながら、評価は分離したまま10反復ごとに行うことです。
選んだロールアウトは8環境を使い、各環境のホライズンを128判断として、1024判断のバッチを作ります。割引率はgamma = 0.99、GAEはlambda = 0.95、PPOのクリップイプシロンは0.2です。各バッチを4更新エポック処理し、ミニバッチは256、学習率は2.5e-4、エントロピー係数は0.01、価値損失係数は0.5、大域勾配ノルムの最大値は0.5です。ブラウザの1回の進行で処理する更新サンプルは最大64個とし、ホールドアウト評価は10反復ごとに予定しています。
環境0は画面に表示する地区へ固定し、見ている人にとってランナーの動きが意味を持つようにします。残りの7環境は、構築時と各エピソード後に、決定論的な巡回カーソルで訓練地区を選びます。幸運な主経路ではなく分布そのものが、443個の観測値を読む方策への圧力になる設計です。
判断ごとの報酬は、DQN実験室と意図的に同じにします。判断ごとに-0.01、新しい水平進行に+ progress_px / TILE、チェックポイントごとに+2、完走で+20、死亡で-2です。定義を固定すれば将来の報酬曲線を比較できますが、その曲線はまだ一つもありません。
保存する人間のデモは、60 Hzのゲームエンジンティックごとに4ビットのニブルを一つ持ちます。ビット0は左、ビット1は右、ビット2はジャンプ、ビット3はダッシュです。Skyline Runの固定ステップエンジンは決定論的なので、同じニブル列は同じレベルとエンジン版で同じプレイを再現します。記録器は完走したプレイだけを保存し、読込器は再生して現在も完走することを確認します。
強化学習の前に、任意の行動クローニング段階で有効な各デモを再生し、行動判断ティックごとに観測を複製して、アクターの8個の離散行動の一つをラベルにします。人間は4ボタンを自由に組み合わせるため、入力が8行動のどれにも一致しない場合があります。そこで投影は最小ハミング距離、つまり異なるボタンビットの最小個数を持つ行動を選び、同点なら行動番号で決めます。アクターには、行動クローニングを10エポック、バッチサイズ64、学習率1e-3、最大50,000サンプルで行います。交差エントロピーは投影した行動ラベルを訓練しますが、クリティックを学習させず、人間のタイミングが投影後も残る保証もありません。
PPOモデルファイルが書き出すのはアクターだけです。そのファイルを読み込むと方策の重みを復元し、新しく初期化したクリティックと最適化器の状態で強化学習を再開します。したがって、この書出しはプレイ可能な方策のスナップショットであり、完全な訓練チェックポイントではありません。
未見レベルのクリアを合格基準にする
既存の評価器が手順を提供します。各モデルはすべてのキャンペーン地区と5個の生成ホールドアウトシードを、レベルごとに3エピソードずつプレイします。全評価は、まずスティッキーアクション(sticky actions)、つまり前の行動を繰り返す仕組みの確率を0にして実行し、次に0.25で再実行します。後者では判断の4分の1が前の行動を繰り返します。比較を再現できるように、モデル、シード、設定、生成レベルのシードを根拠の一部として残します。
重要な結果は、未見の生成レベルをクリアできることです。進行率は方策が止まる場所を知る診断として役立ちますが、クリアを伴わない進行だけでは、移せるプレイ能力を確立できません。遠くまで進んでも未見レベルを一つもクリアできないPPO方策は、記憶の診断が定めた基準をまだ越えていません。
決定的な訓練実行はまだ始まっていない
PPOの反復、行動クローニングのエポック、ホールドアウト評価は、まだ一度も実行していません。この記事は学習曲線、完走、速度向上、他のアルゴリズムに対する優位性を主張しません。
48隠れユニットのアクターには、443個のタイル観測値を頑健な行動へ変える容量が足りないかもしれません。8環境を同期させても、ブラウザのティック予算ではオン方策型手法に必要なサンプルを集められない可能性があります。行動クローニングがラベル雑音を加える恐れもあります。人間は16種類のボタン組合せを使えますが、方策が出せる行動は8種類だけなので、最小ハミング距離による投影は、二つの組合せが同点になる場面で意図を消すかもしれません。
それらは実験結果であり、実装上の言い訳ではありません。平坦な収益曲線、訓練地区への過学習、PPOを悪化させる事前訓練も、この手順では報告すべき結果です。次の手順は、固定済みの訓練と評価を実行することです。次の記事では、訓練した方策が未見レベルをクリアできるかという、ただ一つの問いに答えます。
出典
- Hausknecht, Matthew; Stone, Peter. “Deep Recurrent Q-Learning for Partially Observable MDPs.” AAAI Fall Symposium Series, 2015. arXiv:1507.06527. https://arxiv.org/abs/1507.06527. 2026-08-21閲覧。
- Schulman, John; Wolski, Filip; Dhariwal, Prafulla; Radford, Alec; Klimov, Oleg. “Proximal Policy Optimization Algorithms.” arXiv:1707.06347, 2017. https://arxiv.org/abs/1707.06347. 2026-08-21閲覧。
- Schulman, John; Moritz, Philipp; Levine, Sergey; Jordan, Michael; Abbeel, Pieter. “High-Dimensional Continuous Control Using Generalized Advantage Estimation.” arXiv:1506.02438, 2015. https://arxiv.org/abs/1506.02438. 2026-08-21閲覧。
- Cobbe, Karl; Hesse, Christopher; Hilton, Jacob; Schulman, John. “Leveraging Procedural Generation to Benchmark Reinforcement Learning.” Proceedings of the 37th International Conference on Machine Learning, PMLR 119:2048–2056, 2020. arXiv:1912.01588. https://arxiv.org/abs/1912.01588. 2026-08-21閲覧。
- Huang, Shengyi; Dossa, Rousslan Fernand Julien; Ye, Chang; Braga, João; Chakraborty, Dipam; Mehta, Kinal; Araújo, João G. M. “The 37 Implementation Details of Proximal Policy Optimization.” ICLR Blog Track, 2022. https://iclr-blog-track.github.io/2022/03/25/ppo-implementation-details/. 2026-08-21閲覧。
- Hester, Todd; Vecerik, Matej; Pietquin, Olivier; Lanctot, Marc; Schaul, Tom; Piot, Bilal; Horgan, Dan; Quan, John; Sendonaris, Andrew; Osband, Ian; Dulac-Arnold, Gabriel; Agapiou, John; Leibo, Joel Z.; Gruslys, Audrunas. “Deep Q-learning from Demonstrations.” Proceedings of the AAAI Conference on Artificial Intelligence 32(1), 2018. arXiv:1704.03732. https://arxiv.org/abs/1704.03732. 2026-08-21閲覧。
- Schmitt, Simon; Hudson, Jonathan J.; Zidek, Augustin; Osindero, Simon; Doersch, Carl; Czarnecki, Wojciech M.; Leibo, Joel Z.; Kuttler, Heinrich; Zisserman, Andrew; Simonyan, Karen; Eslami, S. M. Ali. “Kickstarting Deep Reinforcement Learning.” arXiv:1803.03835, 2018. https://arxiv.org/abs/1803.03835. 2026-08-21閲覧。
- Ecoffet, Adrien; Huizinga, Joost; Lehman, Joel; Stanley, Kenneth O.; Clune, Jeff. “First Return, Then Explore.” Nature 590:580–586, 2021. https://doi.org/10.1038/s41586-020-03157-9. 2026-08-21閲覧。
このサイトとAI Maker Labチャンネルは私が所有し、制作しています。これは制作記録であり、第三者による独立したレビューではありません。