
Distritos procedurais: fazendo o Skyline Run testar a política, não a rota
A seed 17 transforma uma rota em teste
A seed 17 espalha 14 plataformas e 13 saltos aceitos pelo motor por uma grade de 136 por 30. Perigos laranja ficam sob alguns vãos, enquanto P, C e G marcam o início, os checkpoints e o objetivo. Os arcos numerados mostram o orçamento de dash — quantos dashes o nível pode exigir sem deixar de ser vencível — de cada salto, não uma rota desenhada à mão.
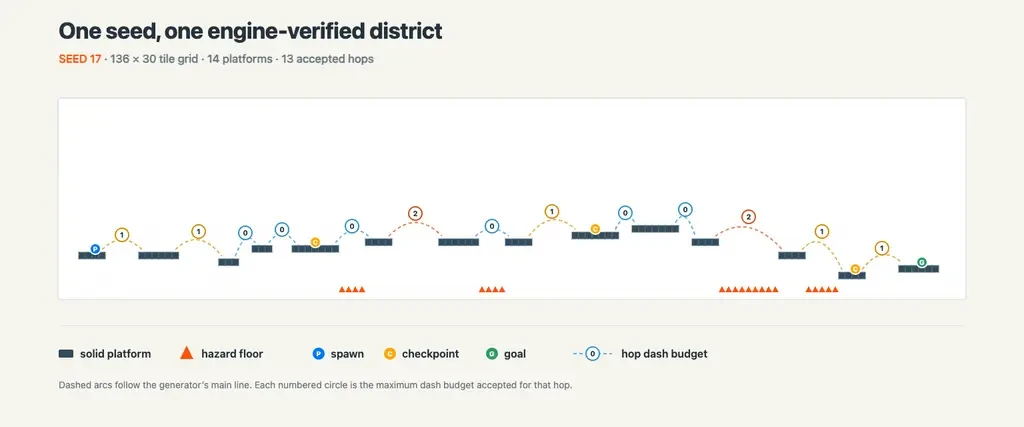
generateSpec(17): 14 plataformas, 13 saltos da linha principal aceitos pelo motor, pisos perigosos e os marcadores P/C/G reais. Os números sobre os saltos são os orçamentos de dash do gerador, não uma rota desenhada à mão.Esse artefato existe para impedir que um único layout vire a tarefa. Uma política avaliada em uma rota fixa pode pontuar repetindo uma sequência de ações bem-sucedida. Se o layout muda a cada episódio, esse atalho perde o valor; a política precisa responder ao que a observação mostra naquele momento.
Essa é a consequência de design da falha de memorização medida que motivou este trabalho. Ela também segue a estrutura experimental do CoinRun, de Cobbe e seus colegas: a geração procedural cria conjuntos distintos de treinamento e teste, e os agentes do estudo apresentaram overfitting até em conjuntos de treinamento surpreendentemente grandes. O ProcGen ampliou esse protocolo para 16 ambientes e relatou que, em alguns casos, os agentes precisaram de até 10.000 níveis de treinamento para fechar a lacuna de generalização.
Uma distribuição não prova generalização. Ela é a configuração mínima para dar sentido a um conjunto de validação retido (hold-out) — níveis que ficam fora do treinamento para que a prática não infle a pontuação.
Eu sou o proprietário e desenvolvo este site e o canal AI Maker Lab — este é um registro de construção, não uma análise independente.
A física medida define limites seguros
Um conjunto de treinamento variado não serve se algumas amostras forem impossíveis. Por isso, o gerador parte de medições da física publicada, não de um desenho apenas visualmente plausível.
A especificação do motor mede um ápice de 56 px — 3,5 tiles — no tick 14 quando o salto é mantido. Manter o botão por um tick alcança 16,56 px. Tempos de um a seis ticks produzem a escada estritamente crescente de 16,56, 22,42, 27,72, 32,62, 37,02 e 40,97 px. Outro teste do motor demonstra que um dash seguido de salto no chão atravessa um vão plano de sete tiles sem dash aéreo.
O envelope mais amplo para vãos planos fixa o alcance em cinco tiles sem dash aéreo, oito com um dash aéreo e onze com dois. Esses valores são máximos medidos em terreno nivelado dentro da busca do teste, não promessas analíticas para uma plataforma acima do ponto de partida. É por isso que o gerador amostra abaixo deles — no máximo 4, 6 ou 9 tiles de vão para orçamentos 0, 1 ou 2 — e ainda exige que o motor prove cada salto individualmente.
A amostragem transforma os limites em distritos
generateSpec(seed) é uma função pura de seed para especificação. Ela cria uma grade de 30 linhas com 10–16 plataformas, isto é, 9–15 saltos na linha principal. As plataformas têm 3–8 tiles de largura. A primeira começa depois de uma margem esquerda de três tiles, o nível termina com quatro tiles à direita da última plataforma, e as linhas das superfícies são limitadas ao intervalo 6–26.
Esses limites servem à física, não apenas à variedade visual. A faixa de plataformas cria várias decisões por episódio sem tornar ilimitada a busca do motor. Larguras de 3–8 tiles oferecem um intervalo real de pouso, em vez de um alvo pontual. O limite vertical preserva espaço acima da rota e reserva linhas abaixo dela para os perigos. As margens assimétricas mantêm o início e o objetivo afastados da borda do mapa.
Para cada salto, o gerador amostra um orçamento de dash com probabilidades de 60% para 0, 30% para 1 e 10% para 2. O orçamento 0 recebe um vão de 2–4 tiles; o orçamento 1, de 5–6; e o orçamento 2, de 7–9. Assim, o caso comum exige movimento normal, enquanto transições caras com dois dashes continuam raras. As três faixas ficam dentro dos limites planos medidos de 5/8/11 tiles, preservando margem para o tempo discreto e as mudanças de elevação.
O delta de linha amostrado é -2..+4. Como os números das linhas crescem para baixo, isso significa uma subida de no máximo duas linhas, mas uma queda de até quatro. Pousos mais altos consomem capacidade vertical, então a amostragem é deliberadamente mais restrita para cima do que para baixo. A linha final da superfície é limitada, portanto um delta amostrado pode ser encurtado perto dos extremos.
Cada vão tem, de forma independente, 30% de chance de receber tiles de perigo ^ na linha 28. O perigo pertence ao vão, nunca à superfície de uma plataforma da linha principal. A primeira versão emite espaço vazio ., sólidos #, perigos ^ e os marcadores P, C e G; ela não emite tiles unidirecionais -. Em seguida, o parser exige exatamente um início P, exatamente um objetivo G e ao menos um checkpoint C antes que uma candidata possa ser avaliada.
O contraste importante é simples: a variedade amostrada entra pela esquerda, mas cada candidata ainda precisa passar pelas verificações concretas no centro antes que os níveis separados à direita possam nos dizer alguma coisa.
| Faixa amostrada | Teste de aceitação | Protocolo do conjunto retido |
|---|---|---|
| 30 linhas; 10–16 plataformas; 9–15 saltos; larguras de 3–8 tiles; superfícies nas linhas 6–26 | Exatamente um P, exatamente um G, ao menos um C e nenhum tile - | Tag de treino 0x6e01; tag do conjunto retido 0x6e02 |
| Orçamentos 0/1/2 com 60%/30%/10%; vãos de 2–4/5–6/7–9 tiles | Um script no motor real precisa pousar em no máximo 180 ticks | O melhor genoma de treino de cada geração roda uma vez em cada nível do conjunto retido |
Delta de linha -2..+4; perigos na linha 28 com 30% de probabilidade | No máximo 10 passagens de reparo por salto e oito tentativas totais de geração | Ticks de validação não entram na contagem de ticks nem no fitness do treinamento |
O jogo publicado veta saltos impossíveis
Eu uso um oráculo de aceitação — uma verificação automática que rejeita um nível gerado antes que um jogador o veja — em vez de confiar em um desenho. canLandOnSegment não aproxima uma parábola nem compara duas distâncias. launchState coloca um GameState real na borda da plataforma de origem, no chão, movendo-se em RUN_SPEED e com o total de três pontos de SP. scriptLands envia quadros de entrada pela função step publicada por no máximo 180 ticks e só aceita depois que um salto ocorreu e o jogador voltou ao chão na altura do destino, sobrepondo sua superfície.
A busca varre ticks de início do salto de 0 a 8. Depois que o salto começa, o script mantém o botão pressionado; esse oráculo não varre as diferentes durações de pressão medidas acima. Com orçamento de um dash, ele também varre um tick de dash de 0 a 40. Com dois dashes, varre o primeiro de 0 a 19, calcula o primeiro momento válido do segundo a partir de DASH_TICKS e DASH_COOLDOWN_TICKS — incluindo o caso especial em que o salto cancela o primeiro dash — e tenta 20 deslocamentos para o segundo. Um salto só é publicado se ao menos um desses scripts no motor real conseguir pousar.
Quando um salto falha, uma passagem de reparo reduz o vão em um tile até o piso de 2 e, se o destino estiver mais alto, também diminui essa subida em uma linha. Esses dois ajustes acontecem na mesma passagem, não em duas fases sequenciais. Depois de no máximo 10 passagens de reparo em um salto, ou quando nenhum dos dois valores pode mudar, a candidata é rejeitada. O gerador então reconstrói o plano inteiro a partir de hashSeed(seed, attempt), com no máximo oito tentativas totais de geração. Aqui, o namespace de hashSeed é uma tag misturada à seed para que dois usos diferentes da mesma seed nunca sorteiem os mesmos números. Esgotar esse limite lança level-gen: unsolvable seed <seed>; não existe fallback silencioso.
A execução medida para as seeds 0–19 é útil porque registra o custo, não somente o limite. A candidata aceita para cada seed não precisou de nenhuma passagem de reparo. Entre as candidatas rejeitadas, houve uma única operação de reparo no total, e as seeds 1, 10 e 18 regeneraram uma vez cada: uma operação de reparo e três regenerações completas em 20 seeds.
Checkpoints mantêm toda rota aceita jogável
Saltos alcançáveis são necessários, mas não suficientes. Dashes gastam SP, e checkpoints o reabastecem. Durante a construção, um checkpoint é inserido antes de um salto que faria o orçamento acumulado ultrapassar os três pontos disponíveis, ou quando quatro intervalos de plataforma se passaram desde o checkpoint anterior. O início conta como o primeiro checkpoint. Em seguida, a construção da candidata audita a rota: restaura o SP para 3 em plataformas de origem com checkpoint e rejeita qualquer salto que o deixaria negativo.
Outras propriedades decorrem do layout. Os marcadores ficam uma linha acima do centro de uma plataforma sólida. Perigos existem apenas na linha 28, em vãos horizontais, enquanto as superfícies das plataformas terminam na linha 26. Assim, início, checkpoints e objetivo têm apoio direto, e suas vizinhanças 3×3 não contêm perigos. As superfícies das plataformas da linha principal são sólidas e livres de perigos por construção.
A especificação verifica mais do que esses argumentos para as seeds 0–19. Ela confirma a altura de 30 linhas; a cadeia de 9–15 saltos; a contagem de plataformas, margens, larguras e limites de linha; índices de segmentos válidos e encadeados; um resultado positivo de canLandOnSegment para cada salto; início e objetivo nas duas pontas da linha principal; apoio sólido e vizinhanças sem perigo para início, checkpoints e objetivo; ausência de perigos nas duas células acima de cada superfície referenciada da linha principal; SP não negativo em toda a rota; e ausência de tiles unidirecionais. O determinismo também é verificado para seeds comuns e com tags representativas. A cadência de “um checkpoint pelo menos a cada quatro plataformas” é estabelecida por checkpointPlatforms; a especificação prova sua consequência energética nas seeds 0–19, em vez de afirmar essa cadência diretamente.
Namespaces separados tornam a memorização visível
As seeds de treinamento são derivadas como hashSeed(seed, GEN_TRAIN_TAG, i), com GEN_TRAIN_TAG = 0x6e01. As do conjunto retido usam hashSeed(seed, GEN_HOLDOUT_TAG, i), com GEN_HOLDOUT_TAG = 0x6e02. O treinador nunca pede intencionalmente ao gerador de treinamento a derivação do conjunto retido, então as duas listas ficam separadas no protocolo.
Isso não é uma garantia matemática à prova de colisões: hashSeed devolve um valor de 32 bits, e a especificação atual do gerador exercita valores representativos dos dois espaços com tags, mas não prova que as duas famílias jamais possam colidir. A afirmação honesta é que há namespaces de derivação separados, não que o vazamento seja impossível para toda entrada de 32 bits. Para essa garantia mais forte, seria preciso verificar colisões explicitamente.
O gráfico do conjunto retido deve ser lido como diagnóstico. A cada geração, ele seleciona o melhor genoma daquela geração no treinamento, executa uma vez em cada nível do conjunto retido e mostra o progresso médio relativo ao ponto inicial junto com a quantidade de níveis do conjunto retido concluídos. Os ticks de validação não entram na contagem de ticks nem no fitness do treinamento. Se a curva de treinamento subir e a do conjunto retido ficar parada, esse é o alerta que este design foi feito para expor; se ambas subirem, há uma evidência que merece investigação, não uma prova de generalização além da família retida escolhida.
O gerador e esse diagnóstico já estão disponíveis no laboratório ao vivo da IA do Skyline Run. Agora, o gerador garante que cada salto aceito na linha principal tem um script de pouso no motor real, que a energia dos checkpoints nunca fica negativa e que as listas de treino e do conjunto retido usam derivações separadas. Ele ainda não garante uma generalização melhor: nenhuma execução de treinamento endurecido é relatada aqui, e uma verificação explícita de colisões continua sendo o próximo passo para sustentar uma afirmação mais forte sobre os namespaces.
O próximo experimento pergunta se uma política consegue agir sobre o nível à sua frente em vez de repetir um timing de sorte: Aprendendo a ler o nível: substituindo saltos de sorte por um gradiente de política.
Fontes
- Cobbe, Karl; Klimov, Oleg; Hesse, Chris; Kim, Taehoon; Schulman, John. “Quantifying Generalization in Reinforcement Learning.” arXiv:1812.02341, 2018. https://arxiv.org/abs/1812.02341. Acessado em 2026-08-21.
- Cobbe, Karl; Hesse, Christopher; Hilton, Jacob; Schulman, John. “Procgen Benchmark.” OpenAI, 2019; artigo associado arXiv:1912.01588. https://openai.com/index/procgen-benchmark/. Acessado em 2026-08-21.
Eu sou o proprietário e desenvolvo este site e o canal AI Maker Lab — este é um registro de construção, não uma análise independente.