
A armadilha da memorização: quando um campeão aprendeu um único distrito
Em agosto, fiz um campeão NEAT exportado — uma rede evoluída por mutações nos pesos e na estrutura — avançar de distrito em distrito no treinador. Ele concluía district-01 repetidamente, e interpretei isso como aprendizado do jogo. Depois, ele concluiu 0 de 30 episódios em três níveis gerados.
Atualizado em 5 de setembro de 2026: reconstruí o laboratório de IA, corrigi fatores numéricos de confusão e executei o treinador pronto sob um benchmark declarado. O artigo agora separa o experimento original dessas novas evidências.
Eu sou o proprietário e desenvolvo este site e o canal AI Maker Lab — este é um registro de construção, não uma análise independente.
O resultado original mostrou sobreajuste, não seu mecanismo exato
O arquivo de agosto concluiu district-01 6 vezes em 10 episódios, com 81,5% de progresso médio. Nos outros nove distritos criados à mão, conseguiu uma única conclusão isolada em 90 episódios. O arquivo era uma política — a rede que mapeia observações para ações — de versão 1 sem histórico de exposição: minhas anotações registram o último distrito criado à mão em que ela treinou, mas o arquivo não consegue provar que os mundos gerados da avaliação eram realmente inéditos. Portanto, devo chamar os três mundos de um conjunto de validação retido (hold-out) nominal, não de testes inéditos garantidos.
A figura original é histórica. Ela compara o mesmo campeão exportado por dez episódios em cada mundo, em uma passagem limpa e outra com ações persistentes (sticky actions), nas quais o ambiente repete a ação anterior com 25% de probabilidade.
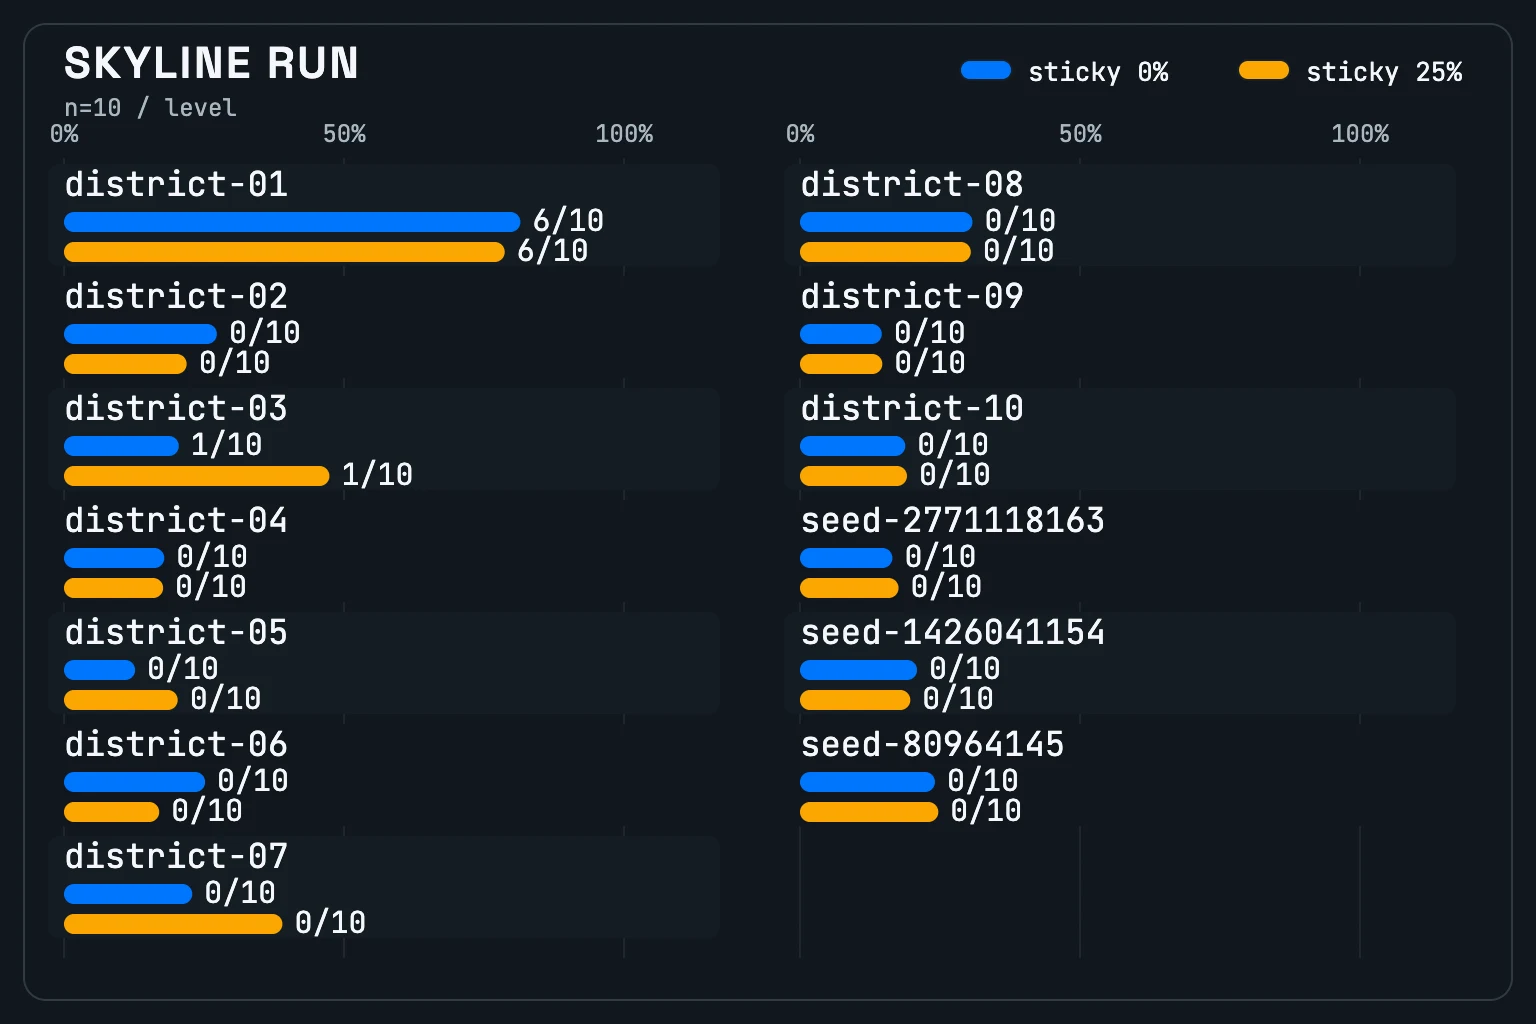
A tabela histórica ainda registra a falha com precisão
Acrescentei uma passagem de evaluateModel que reproduzia o arquivo nos dez distritos criados à mão e em um conjunto selecionado de níveis procedurais. A primeira passagem usou cinco níveis gerados e 3 episódios por nível. Como essa amostra pequena foi ruidosa no único distrito que o modelo conseguia concluir, a tabela histórica estável abaixo usa 10 episódios por nível e três sementes geradas.
Cada episódio recebeu hashSeed(seed, EVAL_STREAM_TAG, levelIndex, episode), por isso a tabela é reproduzível. O progresso é relativo ao ponto inicial do episódio: (maxPx - startPx) / (goal.x * TILE - startPx), limitado ao intervalo [0, 1].
O contraste decisivo é entre as 6/10 conclusões de district-01 e as 0/30 nos três níveis gerados nominalmente retidos.
| Nível | Progresso médio | Conclusões | Mortes médias | Ticks médios |
|---|---|---|---|---|
district-01 | 81.5% | 6/10 | 2.7 | 1379 |
district-02 | 27.3% | 0/10 | 2.0 | 964 |
district-03 | 20.5% | 1/10 | 3.6 | 906 |
district-04 | 17.9% | 0/10 | 4.9 | 562 |
district-05 | 12.7% | 0/10 | 6.3 | 645 |
district-06 | 25.2% | 0/10 | 4.1 | 703 |
district-07 | 22.9% | 0/10 | 4.4 | 764 |
district-08 | 30.8% | 0/10 | 6.2 | 800 |
district-09 | 14.6% | 0/10 | 4.2 | 548 |
district-10 | 18.8% | 0/10 | 6.7 | 729 |
seed-2771118163 | 16.5% | 0/10 | 5.5 | 625 |
seed-1426041154 | 20.9% | 0/10 | 5.9 | 682 |
seed-80964145 | 24.1% | 0/10 | 3.9 | 562 |
A média dos distritos criados à mão foi 27,2%. A média dos níveis gerados foi 20,5%. district-01 foi a única rota concluída repetidamente; os outros nove distritos criados à mão produziram 1 conclusão em 90 episódios no total, e nenhum além de district-03 alcançou 31% de progresso médio.
As ações persistentes enfraqueceram a rota dominada, mas não de forma decisiva. district-01 caiu de 81,5% para 78,7% de progresso médio, enquanto as conclusões permaneceram em 6/10. Na passagem anterior de 3 episódios, caiu de 99,8% e 3/3 conclusões para 67,5% e 1/3. A perturbação também ajudou em algumas falhas: district-03 subiu de 20,5% para 47,4%, district-07 de 22,9% para 39,0%, e a média dos distritos criados à mão de 27,2% para 30,6%. As mortes em district-01 passaram de 2,7 para 1,9, enquanto muitos distritos em que o modelo falhou tiveram médias entre 4 e 7, contra um limite de 8 por episódio.
Esses resultados sustentam um diagnóstico de sobreajuste e mostram baixa transferência. Eles não provam que a rede ignorava suas observações nem que executava uma sequência de ações em malha aberta. Ganhos com ações persistentes podem ocorrer quando uma ação ruim é prolongada por acaso; provar o mecanismo exigiria uma ablação que removesse ou embaralhasse canais de observação e comparasse a mesma política.
A pesquisa anterior tornou a memorização plausível, não comprovada
Hausknecht e Stone mostraram em 2015 que o NEAT podia memorizar sequências de ações em avaliações determinísticas de Atari e depois perder desempenho quando uma leve estocasticidade as perturbava. Mais tarde, Machado e seus colegas explicaram por que a avaliação determinística não consegue, sozinha, distinguir uma política em malha fechada da memorização e padronizaram o protocolo de 25% de ações persistentes que usei na figura histórica.
Cobbe e seus colegas mudaram a unidade de avaliação de um nível para uma distribuição. O CoinRun separa níveis procedurais de treinamento de níveis de teste retidos, e o Procgen amplia essa ideia em um benchmark de ambientes gerados. Esses estudos motivaram meu desenho de teste. Eles tornam plausível a interpretação de memorização, mas não substituem a ablação ausente nem corrigem a ancestralidade desconhecida do arquivo de versão 1.
O treinador antigo premiava uma rota e também tinha fatores numéricos de confusão
O treinador que produziu o arquivo exportado otimizava um nível estático e criado à mão por vez. Cada genoma recebia uma execução (rollout) por geração. Não havia média entre episódios nem conjunto retido. O passo do motor é determinístico; a única aleatoriedade na execução era a substituição de 5% das ações nos ticks de decisão da habilidade casual. Mudar de distrito reconstruía o treinador em torno desse nível e usava o campeão atual como seed, por isso os distritos anteriores deixavam de contribuir para o fitness.
A observação é uma janela egocêntrica de 24 por 18 tiles mais 11 escalares, ou 443 floats; ela não contém posição absoluta nem relógio. Durante a reformulação, descobri que novos genomas NEAT garantiam conexões das entradas 0–10, embora os tiles ocupem 0–431 e o sufixo escalar seja 432–442. Agora, o inicializador conecta todos os escalares a todas as saídas e amostra entradas de tiles apenas no intervalo dos tiles. Esse era um fator de confusão real, mas não prova retroativamente que este campeão específico ignorava o estado.
Corrigi outros três limites de pontuação e execução. O fitness de progresso evolutivo agora mede max(0, maxPx - startPx), para que o deslocamento absoluto de um checkpoint não infle o progresso. DQN, PPO, NEAT baldwiniano, NEAT lamarckiano e ERL agora usam newProgressPx / TILE + 2 * newCheckpoints + 20 * completed - 2 * died como recompensa de transição, mantendo a cobrança separada de -0.01 por decisão. O PPO agora adia uma transição terminal que chega logo após uma execução cheia até que o buffer liberado possa recebê-la exatamente uma vez. Essas correções removem inconsistências evitáveis; não posso afirmar que explicam toda a falha de agosto.
Um contrato de mundos agora chega aos sete métodos
O laboratório de IA do Skyline Run reconstruído mantém GA, DQN, PPO, NEAT, NEAT baldwiniano, NEAT lamarckiano e ERL. Todos os métodos agora recebem o mesmo plano explícito de mundos de treinamento e validação. Candidatos evolutivos são pontuados no lote fixo completo de mundos e episódios de treinamento selecionados antes da reprodução; DQN e PPO percorrem os mundos selecionados preservando seus próprios estados de aprendizado. Episódios de validação nunca entram no fitness nem na memória de repetição.
A seleção agora é uma operação separada. Em limites fixos de treinamento, o worker congela um candidato e o avalia em um plano fixo de validação. A política exportada, salva e observada é o melhor retrato avaliado, não um campeão de fitness bruto incomparável nem quaisquer pesos de DQN/PPO que estivessem atuais. Se uma execução não tem divisão de validação, a interface diz Avaliação no conjunto de treinamento, sem sugerir um conjunto retido.
Um teste manual serve apenas para relatório: ele não pode substituir a política selecionada. Arquivos de política de versão 2 registram o plano de treinamento, a exposição conhecida de treinamento e validação, o limite selecionado e seu relatório de avaliação. Arquivos de versão 1 importados continuam utilizáveis, mas sua ancestralidade é marcada como desconhecida em vez de inventada. Mundos de teste gerados excluem toda exposição efetivamente registrada; quando a ancestralidade é desconhecida, um mundo não registrado permanece desconhecido, não comprovadamente inédito.
Esta implementação foi verificada localmente. Não afirmo que ela esteja implantada.
Um orçamento fixo mostrou aprendizado, mas não generalização para mundos gerados
Executei um benchmark com todas as 7 × 3 × 2 = 42 combinações de algoritmo, semente e preset. Cada execução recebeu 2.000.000 de passos reais do ambiente de treinamento, com atuação Expert, sem demonstrações e sem treinador de recompensa. Expert significa ausência de atraso de reação e de corrupção aleatória das entradas. Orçamentos iguais de passos do ambiente não significam computação igual: os métodos realizam quantidades diferentes de trabalho de otimização em torno desses passos.
A seleção de política usou três episódios iniciados no ponto de spawn por mundo, em passagens limpas e com 0.25 de ações persistentes. O teste separado, usado apenas para relatório, incluiu os dez distritos da campanha e cinco mundos de teste gerados, novamente com três episódios iniciados no spawn por mundo nas duas passagens. Nenhuma linha de teste participou da seleção.
A tabela mostra o progresso normalizado mediano de cada política inicial até a política selecionada. Single não tem conjunto retido, por isso sua coluna é uma avaliação no conjunto de treinamento; Generalization usa sua divisão de validação. Estes são resultados de seleção dentro da mesma versão, não comparações de software antes e depois nem resultados de teste.
| Algoritmo | Progresso no conjunto de treinamento Single | Progresso de validação Generalization |
|---|---|---|
| GA | 9.7% → 71.4% | 4.6% → 12.6% |
| DQN | 0.1% → 59.5% | 6.7% → 15.6% |
| PPO | 11.0% → 99.7% | 6.4% → 24.2% |
| NEAT | 0.0% → 61.3% | 7.8% → 18.1% |
| NEAT baldwiniano | 0.0% → 33.1% | 7.8% → 22.7% |
| NEAT lamarckiano | 0.0% → 42.4% | 7.8% → 22.1% |
| ERL | 0.0% → 52.3% | 7.8% → 18.1% |
Todas as 14 medianas de preset por algoritmo cumpriram a regra declarada de ganho dentro da versão: mais conclusões ou, com o mesmo número de conclusões, pelo menos +0.05 de progresso normalizado médio. A comparação mais restrita entre antes e depois da reformulação melhorou apenas Single NEAT, Single ERL e Generalization NEAT. A linha de base do PPO anterior à reformulação falhou, então não inventei uma comparação substituta. As linhas de base multinível antigas de GA, DQN, NEAT baldwiniano, NEAT lamarckiano e ERL não tinham suporte; as novas execuções demonstram que esses métodos usam o contrato multinível comum, não que superam um passado fabricado.
O resultado decisivo é negativo. Entre as 42 políticas selecionadas, houve exatamente 0/630 conclusões em episódios limpos de teste gerado e 0/630 em episódios com ações persistentes em 0,25. Nenhum método estabeleceu generalização neste benchmark. A mediana de conclusões no distrito principal do PPO Single chegou a 100%, mas apenas as sementes 1 e 3 concluíram; a semente 2 não. O nome do preset Generalization descreve sua configuração mais ampla de mundos, não um resultado, e ele não foi universalmente melhor.
A pergunta em aberto passou do aprendizado para a transferência
A reformulação respondeu se o laboratório consegue treinar e selecionar políticas sob um contrato reproduzível: as catorze medianas de grupo melhoraram em relação às próprias políticas iniciais. Ela não respondeu como transformar esse aprendizado em uma conclusão num mundo gerado. Minha pergunta restante é concreta: qual mudança na diversidade de treinamento ou no viés indutivo pode produzir a primeira conclusão em um teste gerado usado apenas para relatório, sem deixar esse teste influenciar a seleção?
O próximo capítulo do registro, Distritos procedurais: ensinando gramática de jogo ao gerador, explica como construí a distribuição de mundos que agora torna essa pergunta mensurável.
Fontes
- Hausknecht, Matthew; Stone, Peter. “The Impact of Determinism on Learning Atari 2600 Games.” AAAI Workshop on Learning for General Competency in Video Games, 2015. https://www.cs.utexas.edu/~pstone/Papers/bib2html-links/AAAI15-hausknecht.pdf. Acessado em 2026-08-21.
- Machado, Marlos C.; Bellemare, Marc G.; Talvitie, Erik; Veness, Joel; Hausknecht, Matthew; Bowling, Michael. “Revisiting the Arcade Learning Environment: Evaluation Protocols and Open Problems for General Agents.” arXiv:1709.06009, 2018. https://arxiv.org/abs/1709.06009. Acessado em 2026-08-21.
- Cobbe, Karl; Klimov, Oleg; Hesse, Chris; Kim, Taehoon; Schulman, John. “Quantifying Generalization in Reinforcement Learning.” arXiv:1812.02341, 2018. https://arxiv.org/abs/1812.02341. Acessado em 2026-08-21.
- Cobbe, Karl; Hesse, Christopher; Hilton, Jacob; Schulman, John. “Procgen Benchmark.” OpenAI, 2019. https://openai.com/index/procgen-benchmark/. Acessado em 2026-08-21.
Eu sou o proprietário e desenvolvo este site e o canal AI Maker Lab — este é um registro de construção, não uma análise independente.