
プロシージャル地区:Skyline Runで経路ではなく方策を試す
シード17が一つの経路をテストに変える
シード17は、136×30のグリッドに14個の足場と、ゲームエンジンが受理した13回の移動を並べます。一部の隙間の下にはオレンジ色のハザードがあり、P、C、Gが開始地点、チェックポイント、ゴールを示します。番号付きの弧が示すのは、手描きの経路ではなく、攻略に必要としてよいダッシュ回数を表す各移動のダッシュ予算です。
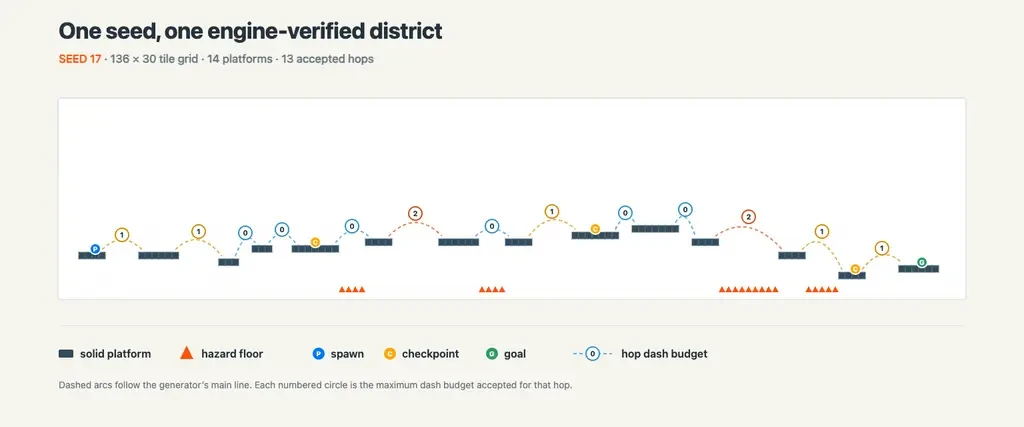
generateSpec(17)が返したシード17そのものです。14個の足場、ゲームエンジンが受理した13回のメインライン移動、ハザード床、実際のP/C/Gマーカーを描いています。移動上の数字は生成器のダッシュ予算であり、手描きの経路ではありません。この成果物の役割は、一つのレイアウトがタスクそのものになるのを防ぐことです。固定経路だけで評価される方策は、成功した一連の操作を再生するだけでも得点できます。エピソードごとにレイアウトが変われば、その近道には価値がなくなり、方策は現在の観測に応じて行動しなければなりません。
これが、今回の制作を始めるきっかけになった測定済みの暗記失敗から導いた設計上の結論です。CobbeらのCoinRunも同じ実験構造を採用しました。プロシージャル生成で訓練集合とテスト集合を分けたところ、驚くほど大きな訓練集合でもエージェントは過学習しました。ProcGenはこの手順を16環境へ広げ、一部では汎化ギャップを閉じるために最大10,000レベルの訓練が必要だったと報告しています。
分布を使うだけで汎化が証明されるわけではありません。ホールドアウト集合、つまり訓練から外しておき、練習によって得点を水増しできないレベル群に意味を持たせるための最低条件です。
このサイトとAI Maker Labチャンネルは私が所有し、制作しています。これは制作記録であり、第三者による独立したレビューではありません。
測定した物理挙動が安全な境界を決める
多様な訓練集合でも、解けないサンプルが混ざれば役に立ちません。そのため、生成器は見た目だけがもっともらしい図ではなく、出荷済みの物理挙動の測定値から出発します。
エンジン仕様では、ジャンプを押し続けたときの頂点を56 px、つまり3.5タイル、到達ティックを14と測定しています。1ティックだけ押すと16.56 pxです。1〜6ティックの長押しでは、16.56、22.42、27.72、32.62、37.02、40.97 pxと厳密に増加します。別のエンジンテストでは、地上ダッシュからのジャンプが、空中ダッシュを使わずに平坦な7タイルの隙間を越えることも実証しています。
より広い平坦な隙間の測定では、ジャンプのみの上限が5タイル、空中ダッシュ1回で8タイル、2回で11タイルに固定されています。これはテストの探索範囲で測った同じ高さの地面に対する最大値であり、着地点が高い場合まで保証する解析値ではありません。そこで生成器は、予算0、1、2に対して最大4、6、9タイルと、その内側からサンプルし、それでも個々の移動をゲームエンジンに証明させます。
サンプリングが境界を地区に変える
generateSpec(seed)はシードから仕様を返す純粋関数です。30行のグリッドに10〜16個の足場、つまりメインライン上に9〜15回の移動を作ります。足場幅は3〜8タイルです。最初の足場の左には3タイル、最後の足場の右には4タイルの余白があり、表面の行は6〜26に制限されます。
これらの範囲は、見た目の変化だけでなく物理挙動のためにあります。足場数の範囲は、1エピソードに複数の判断を与えながら、エンジン探索を有限に保ちます。3〜8タイルの幅は、点ではなく実際の着地区間を作ります。上下の制限は経路の上に余裕を残し、下側にハザード用の行を確保します。左右非対称の余白は、開始地点とゴールをマップ端から離します。
各移動のダッシュ予算は、0が60%、1が30%、2が10%です。予算0には2〜4タイル、予算1には5〜6タイル、予算2には7〜9タイルの隙間を割り当てます。通常移動が最も多く、2回のダッシュを要する高コストな移動はまれです。三つの範囲はいずれも、測定済みの平坦上限5/8/11タイルの内側にあり、離散的な入力タイミングと高低差のための余裕を残します。
行の変化量は-2..+4から選びます。行番号は下向きに増えるので、上昇は最大2行、下降は最大4行です。高い着地点は垂直方向の能力をより使うため、上昇側を下降側より厳しくしています。最終的な表面行は範囲内に丸められるため、境界付近では選ばれた変化量が短くなる場合があります。
各隙間には独立に30%の確率で、28行目に^ハザードタイルが置かれます。ハザードは隙間にだけあり、メインラインの足場表面には置かれません。最初の版が出力するのは空白.、固体#、ハザード^、マーカーP、C、Gで、-の一方向タイルは出力しません。その後、パーサーが開始地点Pを厳密に一つ、ゴールGを厳密に一つ、チェックポイントCを一つ以上要求してから候補を評価します。
重要な対比は単純です。左側の広い範囲からサンプルしても、中央の具体的な検査を通らなければ候補にはなれず、右側の別にした検証レベルにも意味が生まれません。
| サンプリング範囲 | 受理テスト | ホールドアウト手順 |
|---|---|---|
| 30行、10〜16個の足場、9〜15回の移動、3〜8タイルの幅、6〜26行目の表面 | Pが厳密に一つ、Gが厳密に一つ、Cが一つ以上、-タイルなし | 訓練タグ0x6e01、ホールドアウトタグ0x6e02 |
| ダッシュ予算0/1/2を60%/30%/10%で選択、隙間は2〜4/5〜6/7〜9タイル | 実ゲームエンジンの入力手順が最大180ティック以内に着地 | 各世代の訓練上の最良ゲノムを各ホールドアウトレベルで1回ずつ実行 |
行の変化量-2..+4、28行目のハザードを30%で配置 | 1移動につき最大10回の修復、生成試行は合計8回まで | 検証ティックを訓練ティック数にも適応度にも含めない |
出荷済みのゲームが不可能な移動を退ける
私は図を信用する代わりに、受理オラクル、つまりプレイヤーが目にする前に生成レベルを自動検査して退ける仕組みを使います。canLandOnSegmentは放物線を近似したり、二つの距離を比べたりしません。launchStateは本物のGameStateを出発足場の端に置き、接地状態、速度RUN_SPEED、満タンの3 SPから開始します。scriptLandsは最大180ティックにわたって、出荷済みのstep関数へ入力フレームを渡します。ジャンプが実際に起き、その後プレイヤーが着地点の高さで接地し、表面と重なった場合だけ受理します。
探索するジャンプ開始ティックは0〜8です。ジャンプ開始後は押し続けます。この判定は、先ほど測定した可変の長押し時間を探索しません。ダッシュ予算が1なら、ダッシュティックも0〜40から探索します。予算が2なら、最初のダッシュを0〜19から選び、DASH_TICKSとDASH_COOLDOWN_TICKSから次に可能な時刻を計算します。ジャンプが最初のダッシュをキャンセルする特別な場合も含め、その時刻から20種類のオフセットで2回目を試します。実ゲームエンジン上で少なくとも一つの入力手順が着地した移動だけを出力します。
失敗した移動には、1回の修復で隙間を下限2へ向けて1タイル縮め、着地点が高い場合はその上昇も同時に1行減らします。二つの修正は別々の段階ではなく、同じ修復処理で行われます。1移動につき最大10回の修復後、またはどちらも変更できなくなった時点で、その候補を棄却します。次にhashSeed(seed, attempt)から地区全体を作り直し、生成試行は合計8回までです。ここでhashSeedの名前空間とは、同じシードの異なる用途で同じ乱数列を引かないよう、シードに混ぜるタグのことです。それでも失敗すればlevel-gen: unsolvable seed <seed>を例外として送出し、黙って別のものへ置き換えることはありません。
シード0〜19の測定実行は、上限だけでなく実際のコストを記録しています。最終的に受理された各シードの候補は、修復を一度も必要としませんでした。棄却された候補まで含めた修復操作は合計1回で、シード1、10、18はそれぞれ地区全体を1回再生成しました。20シード全体で、修復操作1回、全体再生成3回です。
チェックポイントがすべての受理経路を遊べる状態に保つ
着地できるだけでは不十分です。ダッシュはSPを消費し、チェックポイントで補充されます。生成時には、累積ダッシュ予算が3ポイントのプールを超える移動の前、または前のチェックポイントから足場間隔が4回に達したとき、チェックポイントを置きます。開始地点が最初のチェックポイントです。候補の構築時にも経路を監査し、チェックポイントがある出発足場でSPを3に戻し、負になる移動を拒否します。
他の性質はレイアウトから得られます。マーカーは固体足場の中央の1行上に置かれます。ハザードは横方向の隙間の28行目だけにあり、足場表面は26行目までです。そのため開始地点、チェックポイント、ゴールは直下が支えられ、その3×3近傍にハザードはありません。メインラインの足場表面は、構築上、固体かつハザードなしです。
仕様テストはシード0〜19について、これらの論拠以上を確認します。高さ30行、9〜15回の連結した移動、足場数、左右余白、幅、表面行の範囲、有効で連続したセグメント番号、すべての移動で成功するcanLandOnSegment、メインライン両端にある開始地点とゴール、開始地点・チェックポイント・ゴールの固体による支持とハザードのない近傍、参照される各メインライン表面の上2セルにハザードがないこと、経路全体でSPが負にならないこと、一方向タイルがないことを検証します。通常シードとタグ付きシードの代表値では決定性も確認します。「少なくとも4足場ごとにチェックポイント」という間隔はcheckpointPlatformsの構築で成立し、仕様テストは間隔そのものではなく、シード0〜19におけるエネルギー上の帰結を検証しています。
別のシード名前空間が暗記を見える形にする
訓練シードはGEN_TRAIN_TAG = 0x6e01を使い、hashSeed(seed, GEN_TRAIN_TAG, i)で導出します。ホールドアウトシードはGEN_HOLDOUT_TAG = 0x6e02を使い、hashSeed(seed, GEN_HOLDOUT_TAG, i)で導出します。訓練器が訓練用生成器へホールドアウト側の導出を意図的に渡すことはなく、二つのリストは手順上分離されています。
ただし、これは衝突が数学的に不可能という保証ではありません。hashSeedの出力は32ビットであり、現在の生成器仕様は両タグ空間の代表値を実行しますが、二つの系列が決して衝突しないことまでは証明していません。正確に言えるのは導出の名前空間を分けたことであり、すべての32ビット入力で漏洩が不可能ということではありません。より強い保証には明示的な衝突検査が必要です。
訓練器のホールドアウトグラフは診断として読みます。各世代で、その世代の訓練上の最良ゲノムを各ホールドアウトレベルで1回ずつ実行し、開始地点に対する平均進行度と、完了したホールドアウトレベル数を表示します。検証のティックは訓練ティック数にも適応度にも入りません。訓練曲線だけが上がり、ホールドアウトが横ばいなら、まさにこの設計が見つけるべき警告です。両方が上がっても、選んだホールドアウト系列の外まで汎化した証明ではなく、さらに調べる価値のある根拠です。
生成器とこの診断はSkyline Run AIのライブ実験室で利用できます。生成器がいま保証するのは、受理したすべてのメインライン移動に実ゲームエンジン上の着地手順があり、チェックポイント間のエネルギーが負にならず、訓練用とホールドアウト用のリストが別の導出を使うことです。より良い汎化はまだ保証しません。強化した手順による訓練実行はまだ報告しておらず、名前空間についてさらに強い主張をするには、明示的な衝突検査が次の手順です。
次の実験では、方策が幸運なタイミングを繰り返すのではなく、目の前のレベルに反応できるかを問います。レベルを読む学習:幸運なジャンプを方策勾配に置き換えるへ続きます。
出典
- Cobbe, Karl; Klimov, Oleg; Hesse, Chris; Kim, Taehoon; Schulman, John. “Quantifying Generalization in Reinforcement Learning.” arXiv:1812.02341, 2018. https://arxiv.org/abs/1812.02341. 2026-08-21閲覧。
- Cobbe, Karl; Hesse, Christopher; Hilton, Jacob; Schulman, John. “Procgen Benchmark.” OpenAI, 2019; 関連論文 arXiv:1912.01588. https://openai.com/index/procgen-benchmark/. 2026-08-21閲覧。
このサイトとAI Maker Labチャンネルは私が所有し、制作しています。これは制作記録であり、第三者による独立したレビューではありません。