
記憶の罠:チャンピオンが一つの地区だけを覚えたとき
8月、重みと構造の変異で進化させるネットワークであるNEATのチャンピオンを一つエクスポートし、トレーナー上で地区から地区へ進めました。district-01を何度もクリアしたので、ゲームを学んだのだと解釈しました。ところが三つの生成レベルでは、30エピソード中一度もクリアできませんでした。
2026年9月5日更新:AIラボを作り直し、数値上の交絡要因を修正し、完成したトレーナーを明示したベンチマーク条件で実行しました。この記事では、当初の実験と新しい証拠を分けて示します。
このサイトとAI Maker Labチャンネルは私が所有し、制作しています。これは制作記録であり、第三者による独立したレビューではありません。
当初の結果が示したのは過学習であり、正確な仕組みではなかった
8月のエクスポートは、district-01を10エピソード中6回クリアし、平均進捗は81.5%でした。残りの手作り9地区では、合計90エピソード中、偶発的な1回しかクリアしていません。これは露出履歴を持たないバージョン1の方策、つまり観測から行動を選ぶネットワークでした。私の記録には最後に訓練した手作り地区が残っていますが、生成した評価世界が本当に未見だったことをファイルからは証明できません。そのため、三つの世界は名目上のホールドアウト集合であり、未見が保証されたテストとは呼べません。
元の図は歴史的な記録です。同じエクスポート済みチャンピオンを各世界で10エピソード実行し、通常条件とスティッキーアクション(sticky actions)条件を比べています。後者では、環境が25%の確率で直前の行動を繰り返します。
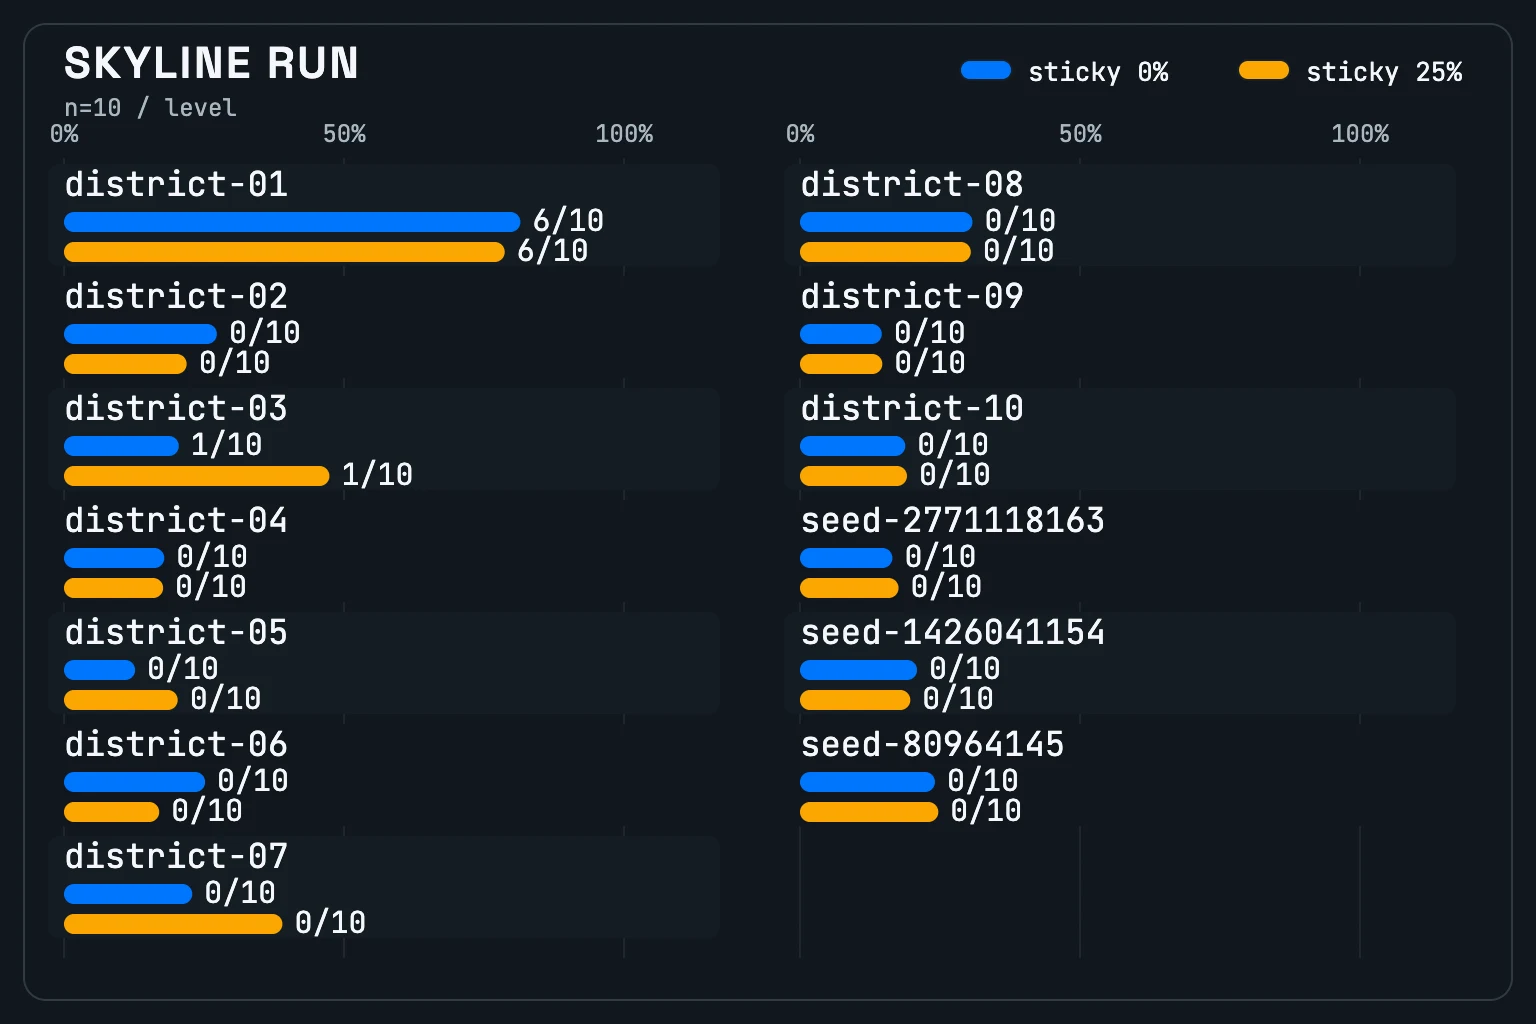
歴史的な表は今も失敗を正確に記録している
エクスポートを手作りの全10地区と、選んだ手続き生成レベルで再実行するevaluateModelを追加しました。最初の実行では生成レベルを5個、各レベル3エピソードで評価しました。クリアできる唯一の地区ではこの小標本のばらつきが大きかったため、以下の安定した歴史的な表では各レベル10エピソード、生成シードは3個にしています。
各エピソードにはhashSeed(seed, EVAL_STREAM_TAG, levelIndex, episode)をシードとして使いました。そのため表は再現できます。進捗はエピソード開始位置を基準とし、(maxPx - startPx) / (goal.x * TILE - startPx)を[0, 1]に収めた値です。
見るべき差は、district-01のクリア6/10に対し、名目上ホールドアウトされた三つの生成レベルでは0/30だったことです。
| レベル | 平均進捗 | クリア | 平均死亡回数 | 平均tick数 |
|---|---|---|---|---|
district-01 | 81.5% | 6/10 | 2.7 | 1379 |
district-02 | 27.3% | 0/10 | 2.0 | 964 |
district-03 | 20.5% | 1/10 | 3.6 | 906 |
district-04 | 17.9% | 0/10 | 4.9 | 562 |
district-05 | 12.7% | 0/10 | 6.3 | 645 |
district-06 | 25.2% | 0/10 | 4.1 | 703 |
district-07 | 22.9% | 0/10 | 4.4 | 764 |
district-08 | 30.8% | 0/10 | 6.2 | 800 |
district-09 | 14.6% | 0/10 | 4.2 | 548 |
district-10 | 18.8% | 0/10 | 6.7 | 729 |
seed-2771118163 | 16.5% | 0/10 | 5.5 | 625 |
seed-1426041154 | 20.9% | 0/10 | 5.9 | 682 |
seed-80964145 | 24.1% | 0/10 | 3.9 | 562 |
手作り地区の平均進捗は27.2%、生成レベルの平均は20.5%でした。繰り返しクリアできた経路はdistrict-01だけです。他の手作り9地区は合計90エピソードでクリア1回にとどまり、district-03以外は平均進捗31%にも達しませんでした。
スティッキーアクションは習得した経路を弱めましたが、決定的ではありません。district-01の平均進捗は81.5%から78.7%へ低下し、クリア回数は6/10のままでした。先に行った3エピソード評価では、99.8%・3/3から67.5%・1/3へ落ちました。一方、摂動が失敗を助けた場合もあります。district-03は20.5%から47.4%、district-07は22.9%から39.0%、手作り地区全体の平均は27.2%から30.6%へ上がりました。district-01の平均死亡回数は2.7回から1.9回へ変わり、失敗した手作り地区の多くは、上限8回に対して4〜7回でした。
これらは過学習の診断と低い転移性能を裏づけます。しかし、ネットワークが観測を無視したことや、開ループの行動列を実行したことまでは証明しません。悪い行動が偶然長く続けば、スティッキーアクションで成績が上がることもあります。仕組みを証明するには、観測チャンネルを除去またはシャッフルし、同じ方策を比較するアブレーションが必要です。
先行研究が示したのは記憶の可能性であり、証明ではなかった
HausknechtとStoneは2015年に、決定論的なAtari評価ではNEATが行動列を記憶し、軽い確率性でその列を乱すと性能を失い得ることを示しました。その後、Machadoらは、決定論的評価だけでは閉ループ方策と記憶を区別できない理由を説明し、歴史的な図で私が使った25%のスティッキーアクション手順を標準化しました。
Cobbeらは、評価単位を一つのレベルから分布へ変えました。CoinRunは手続き生成した訓練レベルとホールドアウトされたテストレベルを分け、Procgenはこの考えを生成環境のベンチマークへ広げました。これらの研究は私のテスト設計の動機です。記憶という解釈をもっともらしくしますが、不足しているアブレーションの代わりにはならず、バージョン1ファイルの不明な系譜も補えません。
古いトレーナーは一つの経路を報酬し、数値上の交絡要因も抱えていた
このモデルを作ったトレーナーは、一度に一つの静的な手作りレベルを最適化していました。各ゲノムの評価は1世代につき1回のロールアウトです。複数エピソードの平均もホールドアウト集合もありませんでした。エンジンのstep自体は決定論的で、ロールアウト内の唯一の乱数は、casualスキルが判断時点で行う5%の行動置換でした。地区を変えると、そのレベルを中心にトレーナーを作り直し、現在のチャンピオンをシードとして与えたため、以前の地区は適応度に寄与しなくなりました。
観測はプレイヤー中心の24×18タイルウィンドウと11個のスカラー、合計443個の浮動小数点値で、絶対位置も時計も含みません。刷新中に、新しいNEATゲノムが入力0–10からの接続を必ず持つ一方、タイルは0–431、スカラーの末尾領域は432–442であることを見つけました。現在の初期化処理は、すべてのスカラーをすべての出力へ接続し、タイル入力をタイル領域だけから抽出します。これは実在した交絡要因ですが、このチャンピオンが状態を無視したという過去への証明にはなりません。
採点とロールアウトの境界も三つ直しました。進化手法の進捗適応度はmax(0, maxPx - startPx)を使い、チェックポイントの絶対位置で進捗が水増しされないようにしました。DQN、PPO、Baldwin型NEAT、Lamarck型NEAT、ERLは、遷移報酬としてnewProgressPx / TILE + 2 * newCheckpoints + 20 * completed - 2 * diedを共有し、別枠の一判断あたり-0.01という費用は維持します。PPOでは、満杯のロールアウト直後に終端遷移が来た場合、空になったバッファへ一度だけ追加できるまで保留します。これらの修正は避けられる不整合を取り除きますが、8月の失敗をすべて説明したとは言えません。
一つの世界契約が七つの手法すべてに届くようになった
作り直したSkyline Run AIラボは、GA、DQN、PPO、NEAT、Baldwin型NEAT、Lamarck型NEAT、ERLを維持しています。すべての手法が、明示された同じ訓練世界と検証世界の計画を受け取ります。進化手法の候補は、選んだすべての訓練世界とエピソードからなる固定バッチ全体で採点されてから繁殖します。DQNとPPOは、それぞれの学習状態を保ったまま選択済みの世界を巡回します。検証エピソードが適応度や経験再生に入ることはありません。
方策選択も独立した処理にしました。決められた訓練境界で候補を凍結し、一つの固定検証計画で評価します。エクスポート、保存、Watchで使うのは、評価で選ばれた最良のスナップショットです。比較不能な生の適応度チャンピオンでも、その時点のDQN/PPO重みでもありません。検証分割がない実行では、UIに訓練集合での評価と表示し、ホールドアウトだとは示しません。
手動テストは報告専用で、選択済み方策を置き換えません。バージョン2の方策ファイルは、訓練計画、判明している訓練・検証への露出、選択境界、その評価報告を記録します。インポートしたバージョン1ファイルも利用できますが、系譜を捏造せず不明と記録します。生成テスト世界は、実際に記録されたすべての露出から除外されます。系譜が不明なとき、記録されていない世界は不明であり、未見が保証されたわけではありません。
この実装はローカルで検証しました。デプロイ済みだとは主張しません。
固定予算で学習は確認できたが、生成世界への汎化は確認できなかった
7 × 3 × 2 = 42通りの手法、シード、プリセットの実行をすべてベンチマークしました。各実行の予算は、実際の訓練環境ステップ2,000,000回です。Expert操作を使い、デモンストレーションも報酬トレーナーも使いませんでした。Expertとは、反応遅延も入力へのランダムな破損もない設定です。環境ステップ数が同じでも計算量は同じではありません。各手法は、そのステップの周囲で異なる量の最適化処理を行います。
方策選択では、各世界をスポーン位置から3エピソードずつ、通常条件とスティッキー確率0.25の条件で評価しました。独立した報告専用テストでは、手作りの全10地区と五つの生成テスト世界を使い、同じく各世界をスポーン位置から3エピソードずつ、二つの条件で評価しました。テスト行は一つも選択に使っていません。
次の表は、各初期方策から選択済み方策までの正規化進捗の中央値です。Singleにはホールドアウトがないため、左列は訓練集合での評価です。Generalizationは検証分割での評価です。ソフトウェア刷新前後の比較でも、テスト結果でもありません。
| 手法 | Singleの訓練集合進捗 | Generalizationの検証進捗 |
|---|---|---|
| GA | 9.7% → 71.4% | 4.6% → 12.6% |
| DQN | 0.1% → 59.5% | 6.7% → 15.6% |
| PPO | 11.0% → 99.7% | 6.4% → 24.2% |
| NEAT | 0.0% → 61.3% | 7.8% → 18.1% |
| Baldwin型NEAT | 0.0% → 33.1% | 7.8% → 22.7% |
| Lamarck型NEAT | 0.0% → 42.4% | 7.8% → 22.1% |
| ERL | 0.0% → 52.3% | 7.8% → 18.1% |
プリセットと手法を組み合わせた14群すべての中央値が、同一バージョン内の事前ルールを満たしました。クリア率が高いか、同率なら平均正規化進捗が少なくとも+0.05高いという基準です。より狭い刷新前後の比較で改善したのは、Single NEAT、Single ERL、Generalization NEATだけでした。刷新前のPPOベースラインは失敗したため、代替の比較を作っていません。GA、DQN、Baldwin型NEAT、Lamarck型NEAT、ERLには古い複数レベルのベースラインがありません。新しい実行が示すのは、共通の複数レベル契約を利用できることだけで、捏造した過去に勝ったということではありません。
決定的なのは否定的な結果です。42個の選択済み方策全体で、生成テストのクリアは通常条件で0/630エピソード、スティッキー確率0.25で0/630エピソードでした。このベンチマークで汎化を確立した手法はありません。Single PPOの主要地区クリア率の中央値は100%でしたが、クリアしたのはシード1と3だけで、シード2は失敗しました。Generalizationというプリセット名は世界構成が広いことを示すだけで、結果を表す名前ではありません。また、常に優れていたわけでもありません。
残った問いは学習できるかではなく、転移できるかになった
刷新により、ラボが一つの再現可能な契約の下で方策を訓練・選択できるかには答えが出ました。14群すべての中央値が、それぞれの初期方策から改善しました。しかし、その学習を生成世界のクリアへ変える方法はまだ分かりません。残った問いは具体的です。報告専用テストを選択へ漏らさずに、訓練世界の多様性または帰納バイアスをどう変えれば、生成テストで最初の1回をクリアできるのでしょうか。
次の制作記録、手続き生成地区:ジェネレーターにゲーム文法を教えるでは、この問いを測定可能にした世界分布をどう作ったかを説明します。
出典
- Hausknecht, Matthew; Stone, Peter. “The Impact of Determinism on Learning Atari 2600 Games.” AAAI Workshop on Learning for General Competency in Video Games, 2015. https://www.cs.utexas.edu/~pstone/Papers/bib2html-links/AAAI15-hausknecht.pdf. 2026-08-21閲覧。
- Machado, Marlos C.; Bellemare, Marc G.; Talvitie, Erik; Veness, Joel; Hausknecht, Matthew; Bowling, Michael. “Revisiting the Arcade Learning Environment: Evaluation Protocols and Open Problems for General Agents.” arXiv:1709.06009, 2018. https://arxiv.org/abs/1709.06009. 2026-08-21閲覧。
- Cobbe, Karl; Klimov, Oleg; Hesse, Chris; Kim, Taehoon; Schulman, John. “Quantifying Generalization in Reinforcement Learning.” arXiv:1812.02341, 2018. https://arxiv.org/abs/1812.02341. 2026-08-21閲覧。
- Cobbe, Karl; Hesse, Christopher; Hilton, Jacob; Schulman, John. “Procgen Benchmark.” OpenAI, 2019. https://openai.com/index/procgen-benchmark/. 2026-08-21閲覧。
このサイトとAI Maker Labチャンネルは私が所有し、制作しています。これは制作記録であり、第三者による独立したレビューではありません。